

Un Master Patient Index (MPI) est un système de base de données en santé qui identifie de manière unique chaque patient à travers de multiples dossiers et systèmes sources. L'acronyme MPI désigne spécifiquement le sous-système d'identité des patients au sein de la gestion des données maîtres (Master Data Management, ou MDM) en santé. Un MPI consolide les dossiers en double, alimente la liaison de dossiers et fournit aux prestataires de soins une vue unique et exacte de chaque patient.
Également appelé Index des patients ou Index des patients en santé dans certains contextes, le MPI constitue la colonne vertébrale des systèmes de données centrés sur le patient. Plus les prestataires de soins disposent d'informations sur un patient, meilleurs sont les soins qu'ils peuvent prodiguer — mais seulement si ces informations sont correctement associées à la bonne personne.
Des protocoles normalisés comme FHIR, soutenus par des réglementations nationales, facilitent la collecte de données sur les patients provenant de laboratoires, d'hôpitaux, de centres de diagnostic, etc. Toutefois, déterminer si différents dossiers appartiennent à la même personne ou contiennent des données dupliquées peut représenter un défi. C'est le problème fondamental que le Master Data Management (MDM) en santé est conçu à résoudre — et le Master Patient Index (MPI) en est le sous-système centré sur le patient, associé à un algorithme de liaison de dossiers approprié.
Dans cet article, nous aborderons :
- Ce que sont le Master Patient Index (MPI) et la liaison de dossiers, et comment ils s'inscrivent dans le Master Data Management en santé ;
- Comment mettre en œuvre un MPI et quelles méthodes peuvent être utilisées ;
- Comment choisir le bon algorithme de liaison de dossiers.
Qu'est-ce qu'un Master Patient Index (MPI) ?
Le Master Patient Index (MPI) est un logiciel utilisé dans les organisations de santé pour identifier de manière unique chaque patient et consolider leurs multiples dossiers. Il permet de s'assurer que tous les prestataires de soins ont accès à des informations exactes sur les patients.
La liaison de dossiers (Record Linkage) est le processus d'appariement des dossiers en double. L'algorithme d'appariement (la méthode) est au cœur du Master Patient Index. Il calcule la similarité entre deux dossiers et détermine s'ils sont identiques.
Astuce : Si vous cherchez un outil complet pour gérer les dossiers des patients, le terme « Master Patient Index » est un mot-clé utile pour vos recherches. Si vous souhaitez plutôt comprendre son fonctionnement, continuez simplement la lecture de cet article et cherchez ensuite « Record Linkage » sur le Web.
Comment le MPI s'inscrit dans le Master Data Management en santé
Le Master Data Management (MDM) en santé est la discipline qui consiste à construire une vue unique et fiable des entités sur lesquelles repose le reste du système — patients, prestataires, organisations, lieux, payeurs. Chacune de ces entités présente ses propres particularités, mais le modèle d'ingénierie est le même : ingérer à partir de nombreux systèmes sources, apparier les dossiers qui font référence à la même entité du monde réel, et résoudre les conflits en un dossier maître dont les consommateurs en aval peuvent se fier.
Le Master Patient Index est la composante spécifique aux patients dans cet ensemble. C'est de loin la partie la plus discutée du MDM en santé, car l'identité des patients est là où les erreurs coûtent le plus : un dossier patient dupliqué fragmente un historique clinique ; un dossier fusionné à tort crée un événement lié à la sécurité. Ainsi, lorsque les équipes parlent de « MPI », elles désignent presque toujours une capacité de Master Data Management limitée à Patient — les mêmes mécanismes d'appariement, de regroupement, de fusion et d'audit que l'on utiliserait pour toute autre entité maître, appliqués là où les enjeux sont les plus élevés.
Dans la suite de cet article, nous examinons le fonctionnement concret de ces mécanismes.
Comment fonctionne un Master Patient Index
La mise en œuvre du Master Patient Index suit un processus en plusieurs étapes clés :
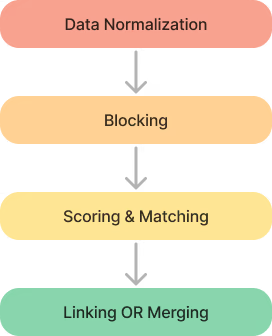
- Nettoyage et normalisation des données — nettoyer les données et standardiser leur format ;
- Regroupement (Blocking) — prégrouper les dossiers pour réduire le nombre de comparaisons et améliorer les performances ;
- Évaluation et appariement (Scoring & Matching) — le « cœur » du processus : identifier la similarité des dossiers et effectuer un appariement automatique ou manuel ;
- Liaison ou fusion des dossiers en double.
Examinons maintenant chaque étape plus en détail.
Master Patient Index : Nettoyage et normalisation des données
Premièrement, nous nettoyons les données.
Assurez-vous que les identifiants (comme l'adresse, le sexe, le NAS, etc.) sont formatés de manière cohérente afin d'obtenir des résultats plus précis. Cela peut être réalisé en supprimant la ponctuation, en convertissant en majuscules et en standardisant les valeurs.
Normalisez les terminologies : bien que le Sexe puisse être représenté par « Male/Female » dans un jeu de données et « Man/Woman » dans un autre, il devrait être codé de la même manière.
Si une valeur est invalide et n'a été saisie que pour remplir un champ obligatoire (p. ex. « Baby boy » dans le champ Prénom ou « 00000000 » pour un numéro d'assurance sociale), il est recommandé de réinitialiser cette valeur à « NULL », car l'algorithme peut être sensible à de telles entrées.
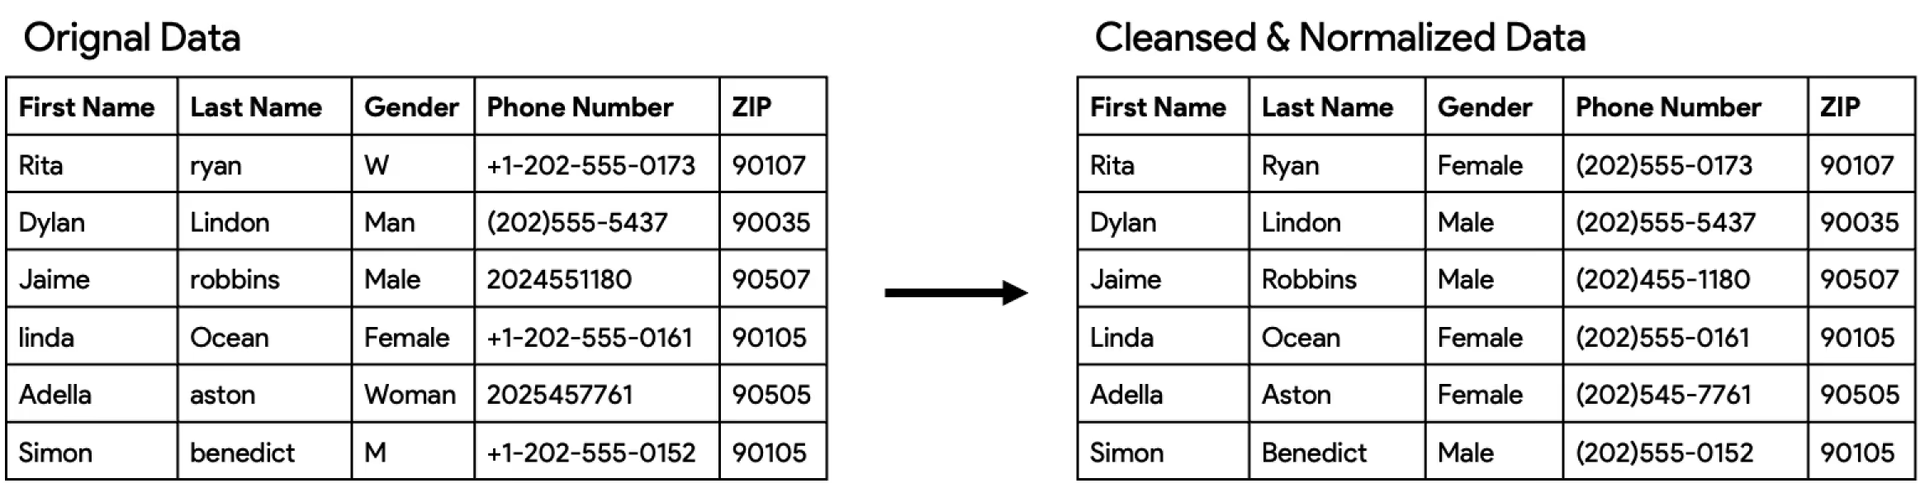
La situation idéale se produit lorsque votre source de données fournit des données propres dans le même format (mêmes noms d'attributs), mais ce n'est pas toujours le cas et il faut généralement convertir vos données dans un format commun.
Nous recommandons d'utiliser HL7 FHIR pour les formats de données normalisés, car nous observons une adoption significative de FHIR et il semble que FHIR deviendra une lingua franca pour l'échange de données en santé dans un avenir proche. Notre solution Master Patient Index & Master Data Management, MDMbox, est implantée sur FHIR.
Master Patient Index : Regroupement (Blocking)
Une fois les données nettoyées et normalisées, nous pouvons amorcer le processus de regroupement des dossiers. Si un Master Patient Index contient un million de dossiers, une comparaison directe de tous les dossiers nécessiterait mille milliards de comparaisons, mais il est possible de réduire ce nombre de manière significative.
Cela implique généralement de faire passer le jeu de données à travers une série de filtres, en utilisant chaque fois un attribut ou une méthode différente pour identifier les correspondances possibles, mais il y a un compromis entre performance et précision et il est important de choisir la bonne clé de regroupement.
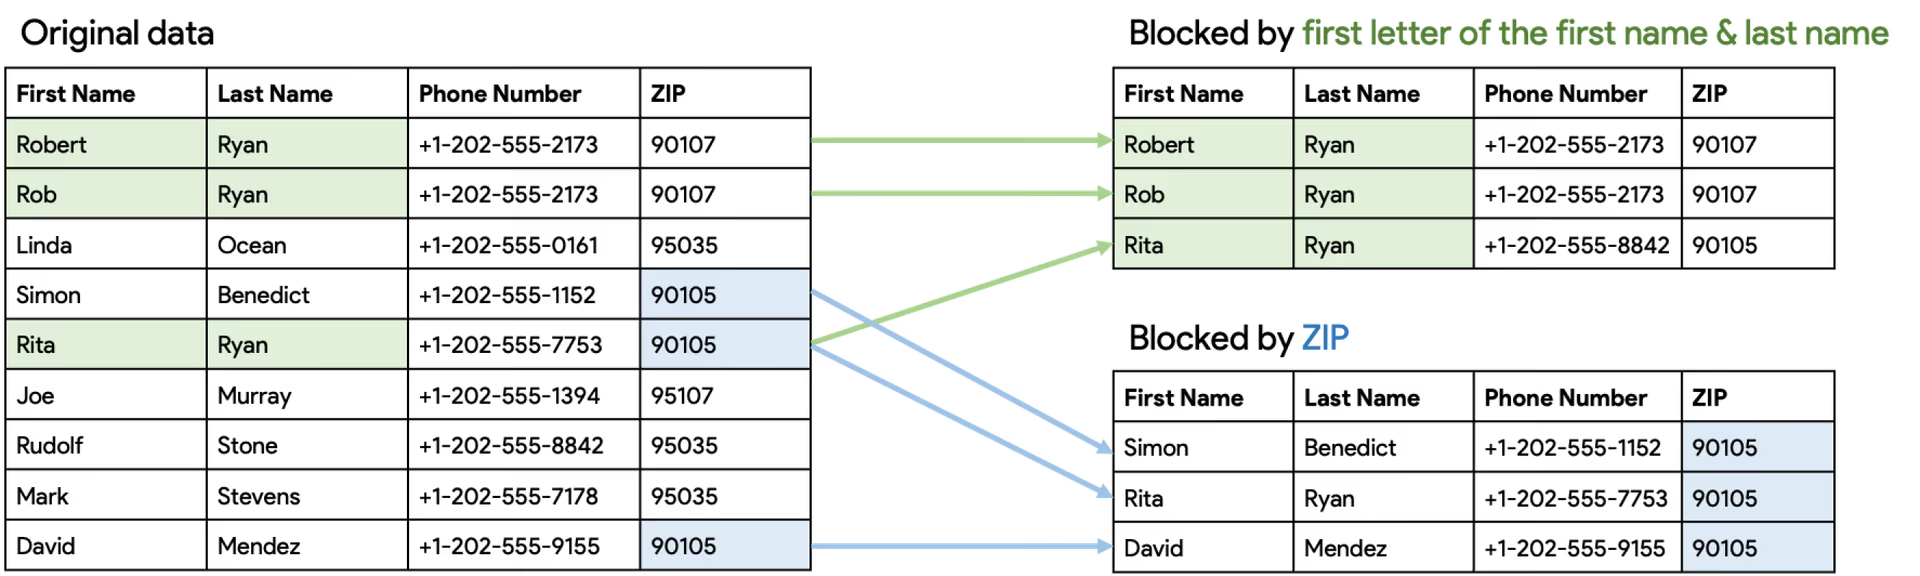
Le regroupement consiste typiquement à diviser les dossiers en groupes plus petits — ou « blocs » — selon certains critères (filtres), par exemple en utilisant une similarité approximative (comme le prénom, le sexe, l'année de naissance, le code postal, etc.).
Comme on peut le voir dans le schéma d'exemple ci-dessous, une opération de regroupement peut générer des blocs candidats à l'aide de l'attribut Nom de famille et de la première lettre du Prénom, ou elle peut créer des blocs à l'aide d'autres attributs, comme le Numéro de téléphone ou le Code postal :
L'appariement est ensuite effectué à l'intérieur du bloc, ou entre deux blocs relevant du même attribut :
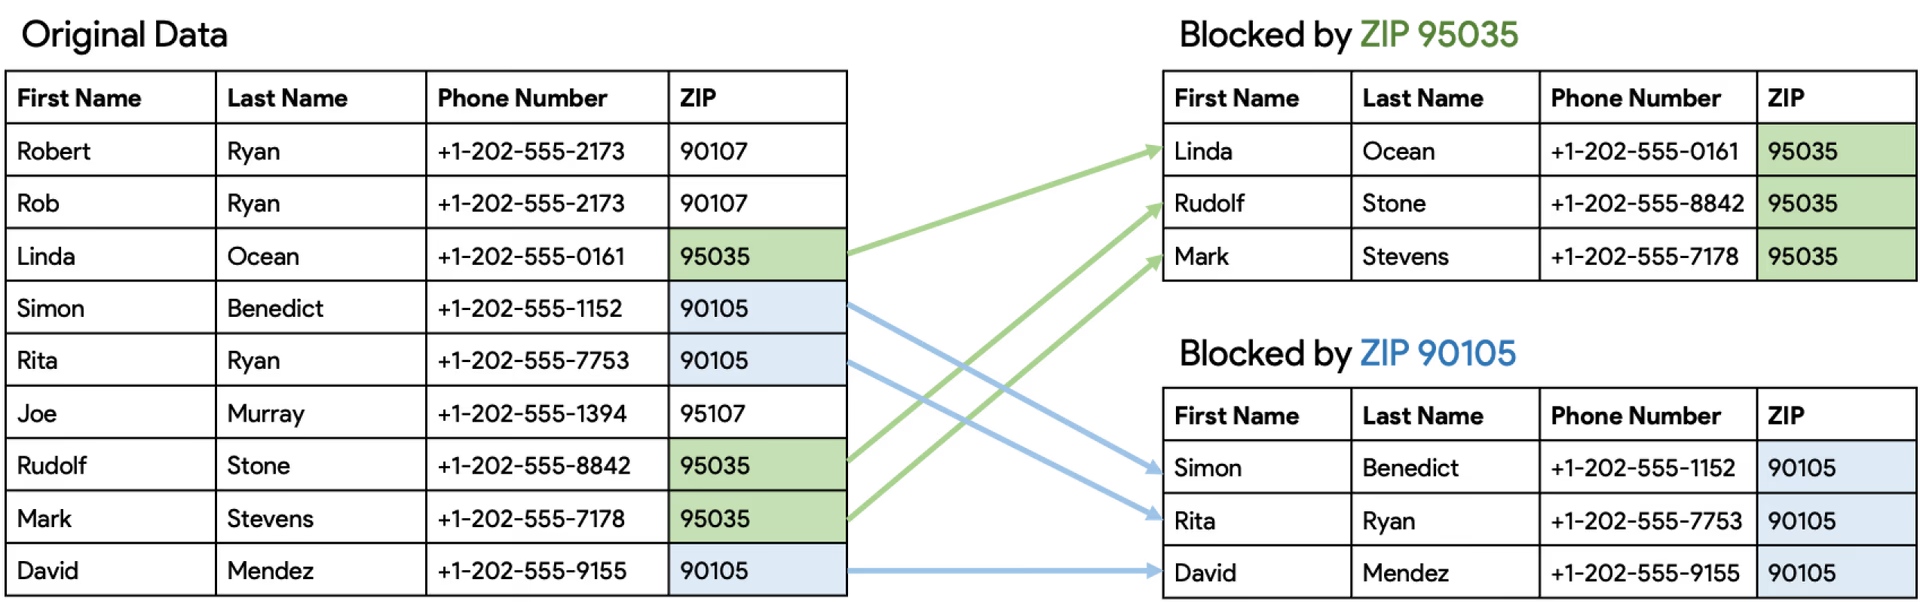
Il convient de noter que différentes exécutions de cette opération peuvent révéler différentes correspondances réelles, de sorte que la combinaison des résultats peut potentiellement mettre en évidence la majorité des correspondances vraies.
L'objectif est de minimiser le nombre de candidats ; les lignes directrices doivent donc être :
- Suffisamment larges pour englober tous les dossiers pertinents dans le même bloc ;
- Suffisamment précises pour permettre une comparaison efficace des candidats dans un délai raisonnable.
Master Patient Index : Évaluation et appariement (Scoring & Matching)
Le « cœur » du Master Patient Index est le processus d'évaluation et d'appariement, et à cette étape, il est crucial de déterminer si deux dossiers sont susceptibles de se rapporter au même individu. Les algorithmes peuvent classer les dossiers en deux groupes — Correspondance ou Non-correspondance — ou en un troisième groupe, Correspondance possible, où la décision peut être déléguée à des personnes.
L'appariement peut être effectué selon différentes méthodes :
- Méthode déterministe (basée sur des règles) — utilise un ensemble de règles (par exemple, le NAS, la date de naissance et le nom de famille correspondent) et est également appelée logique de correspondance exacte. Les règles déterministes peuvent être conçues avec un niveau élevé de spécificité ;
- Méthode probabiliste (basée sur un score ou Fellegi-Sunter) — cette méthode relie les dossiers lorsque la somme de tous les accords pondérés l'emporte sur les désaccords.
Vous pouvez utiliser ce tableau pour comparer rapidement et facilement les méthodes :
| Méthode | Avantages | Inconvénients |
|---|---|---|
| Méthode déterministe (basée sur des règles) Utilise un ensemble de règles (par exemple, le NAS, la date de naissance et le nom de famille correspondent), également appelée logique de correspondance exacte. Les règles déterministes peuvent être conçues avec un niveau élevé de spécificité | Facile à mettre en œuvre. Facile à rédiger et à comprendre grâce à ses règles simples | Précision limitée ou nécessite des extensions complexes pour l'améliorer. Difficile à maintenir un ensemble de règles pour un appariement précis. Très sensible à la qualité des données. Difficile à implanter efficacement pour les grands jeux de données. Aucun moyen de quantifier la qualité de l'algorithme |
| Méthode probabiliste (basée sur un score ou Fellegi-Sunter) Cette méthode relie les dossiers lorsque la somme de tous les accords pondérés l'emporte sur les désaccords | Utilise tous les points de données disponibles pour prendre une décision (correspondance ou non-correspondance). Gère les données manquantes ou invalides. Peut apprendre à partir de statistiques de données existantes et nouvelles. La qualité de l'algorithme (précision et sensibilité) peut être estimée en chiffres. S'adapte bien au regroupement pour les grands jeux de données. Utilisée avec succès pour l'analyse de populations dans de nombreux projets | Nécessite une configuration et un réglage par des experts |
Le MDMbox utilise la méthode probabiliste (modèle basé sur l'algorithme Fellegi-Sunter), qui est un type de classificateur bayésien, et compare les valeurs d'attributs spécifiques comme le prénom, la date de naissance ou le NAS. Si les attributs semblent identiques, cela augmente la probabilité de correspondance, et si les attributs ne correspondent pas, la probabilité de correspondance diminue.
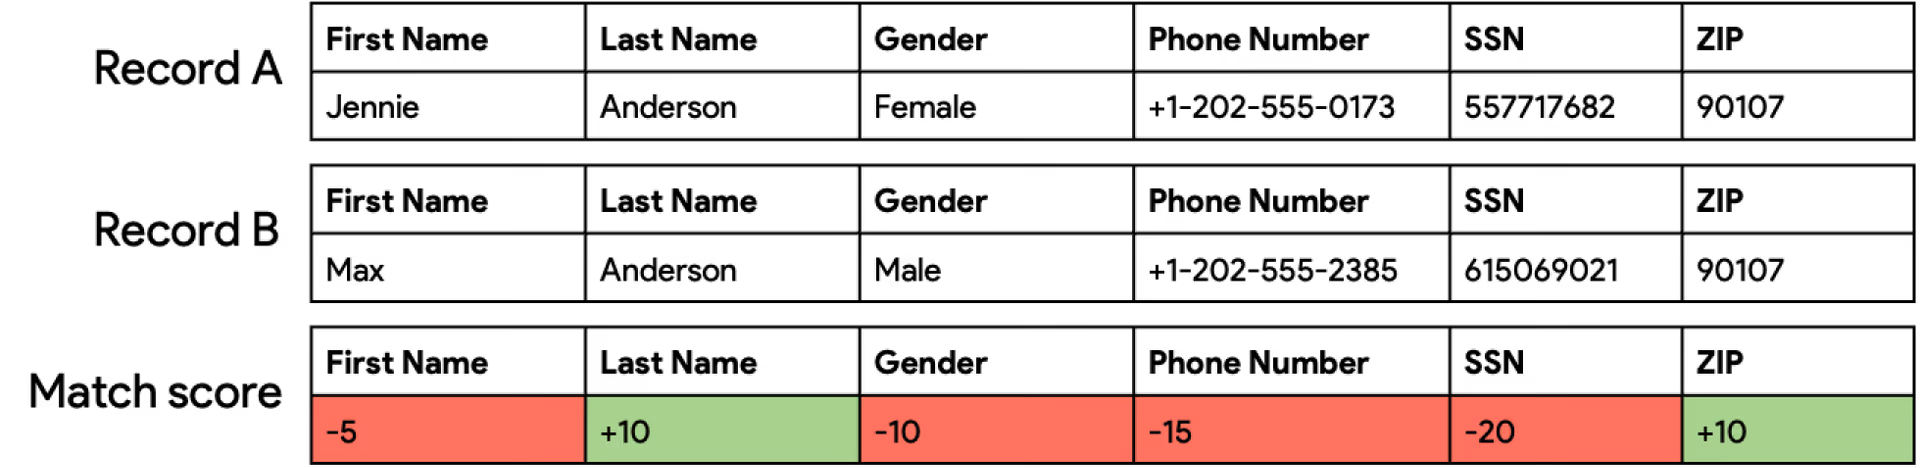
Nous utilisons donc un système qui nous aide à déterminer la probabilité que deux dossiers soient identiques. Nous commençons par estimer la probabilité que deux dossiers choisis au hasard correspondent. Nous comparons ensuite les dossiers pour voir s'ils ont des éléments en commun, comme la même date de naissance, le même NAS ou le même numéro de téléphone.
Voici donc une façon simple et rapide d'expliquer le fonctionnement de l'algorithme : il compare les dossiers et évalue avec précision les preuves, ce qui nous permet de déterminer la probabilité d'une correspondance :
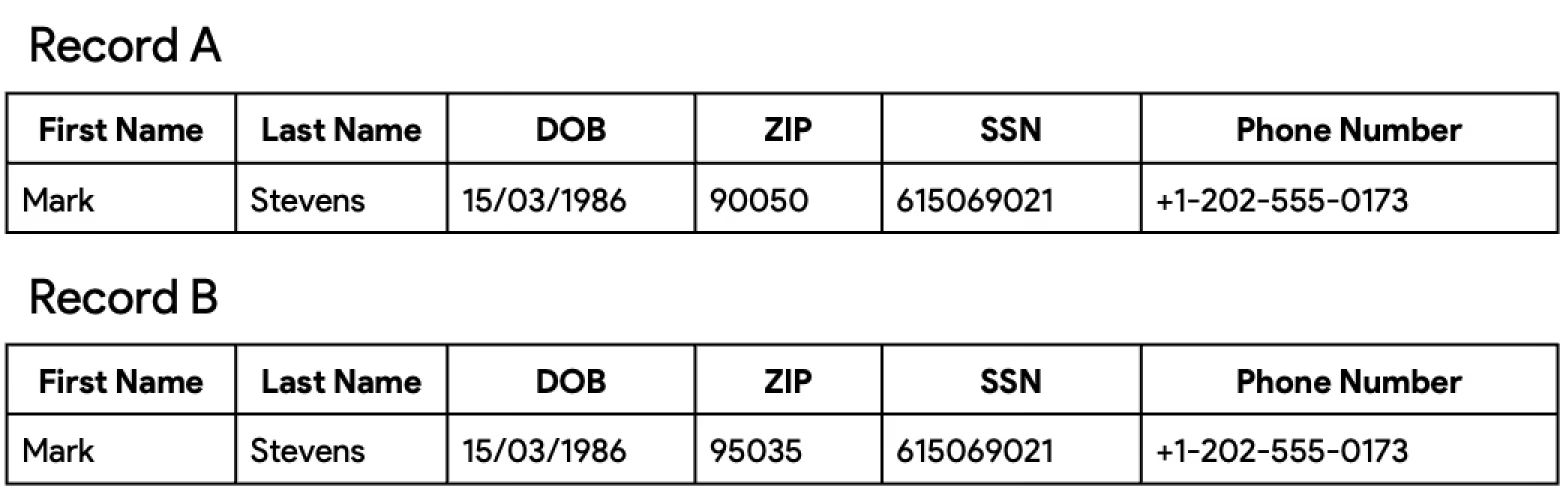
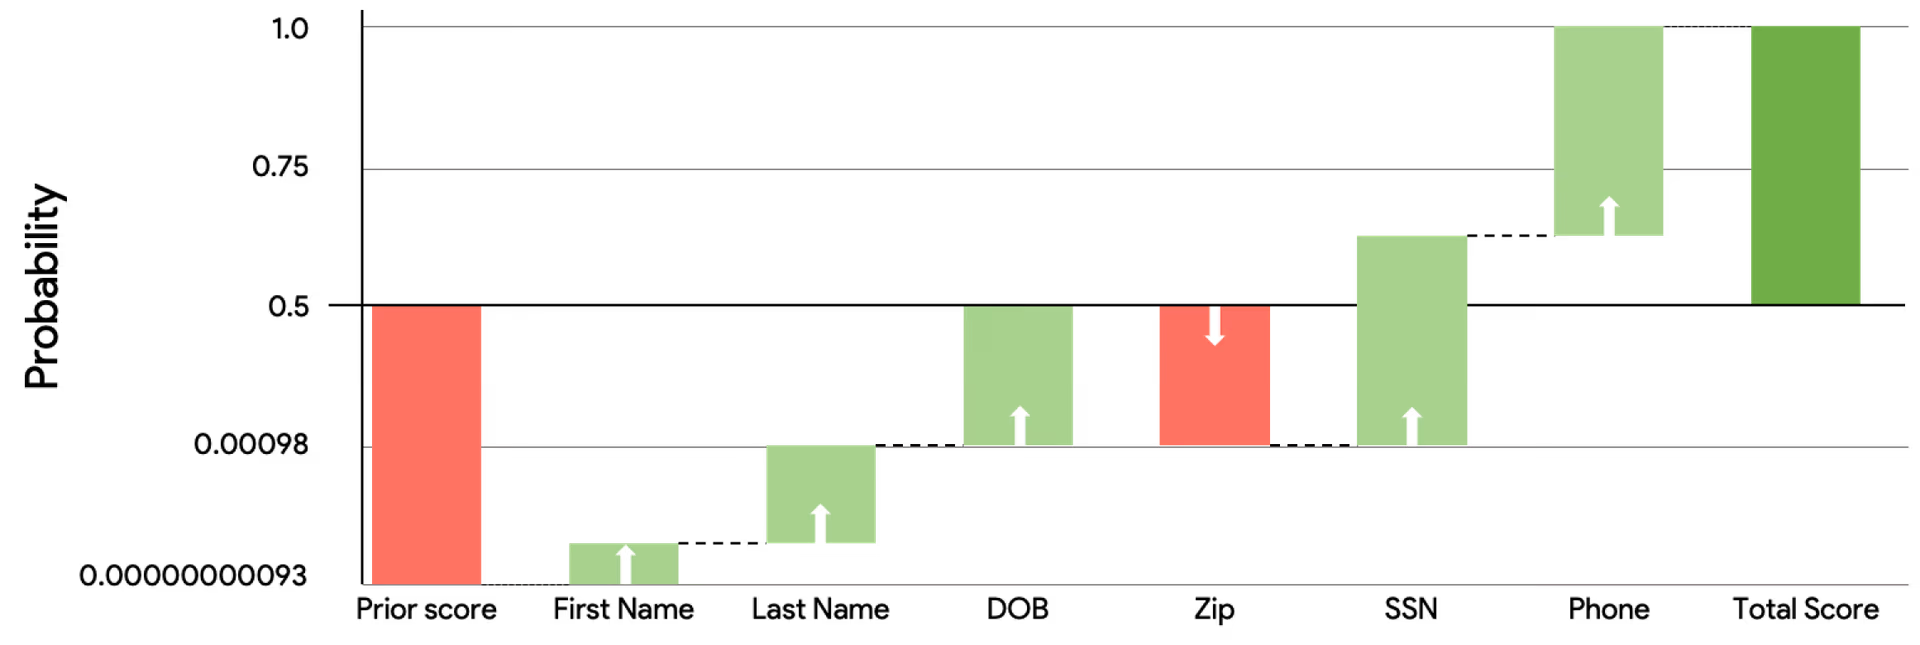
- Les colonnes comportant un plus grand nombre de valeurs uniques, comme la date de naissance, le NAS ou le numéro de téléphone, sont plus susceptibles d'établir une correspondance solide, car il est peu probable que ces valeurs dans deux dossiers sélectionnés au hasard correspondent par coïncidence.
- Lorsqu'une colonne ne correspond pas, c'est généralement une preuve contre une correspondance. Il faut également admettre que cette preuve peut ne pas être entièrement fiable dans les cas où des facteurs externes, comme un changement de nom suite à un mariage, un déménagement entraînant un code postal différent pour le patient, ou une simple faute de frappe lors de la saisie des données, peuvent entraîner une non-correspondance dans la colonne.
Si ce score de preuves total atteint ou dépasse un seuil configurable, appelé valeur de coupure, les dossiers sont considérés comme correspondants et peuvent être appariés. Si le score est inférieur au seuil, les dossiers sont considérés comme appartenant à des personnes distinctes et ne sont pas appariés dans le Master Patient Index.
Une pratique courante consiste à examiner la distribution des scores et à choisir une méthode de similarité qui aboutira à un taux souhaité de faux positifs ou de faux négatifs. Cela peut aider à équilibrer le besoin de précision et la nécessité de minimiser la charge de travail des réviseurs humains. Pour une démonstration pratique de ce calibrage, consultez notre guide sur la configuration et le réglage d'un modèle d'appariement de patients.
Démarrez avec le serveur FHIR Aidbox pour le stockage de données, les intégrations, l'analytique en santé et plus encore, ou engagez notre équipe pour soutenir vos besoins en développement de logiciels.
Choisir l'algorithme d'appariement
Par défaut, Fellegi-Sunter semble être l'option la plus appropriée. Il nécessite qu'un expert le configure et le paramètre, mais peut produire de bons résultats.
Si vous avez moins de sources de données fiables avec des relations étroites, de simples règles déterministes suffiront, mais il n'existe aucun moyen d'évaluer leur précision.
Liaison ou fusion ?
Après l'appariement des dossiers, il est important de décider si vous devez lier ou fusionner les dossiers.
- Lier les dossiers signifie que nous conservons tous les dossiers en double tels quels, mais que nous les relions les uns aux autres. Si vous avez des sources différentes pour différents doublons, il n'y aura aucun problème à mettre à jour les dossiers.
Cela est utile dans les cas où les données sont continuellement agrégées à partir de différentes sources, car cela permet au Master Patient Index de suivre les relations entre les dossiers sans avoir à résoudre continuellement des conflits de fusion.
- Fusionner les dossiers signifie combiner les dossiers en un seul dossier hybride.
Cela implique de combiner les données de plusieurs dossiers en un seul dossier contenant toutes les informations pertinentes sur un patient. Comparée à la liaison, la fusion permet une récupération des données plus simple et plus rapide, ainsi qu'une utilisation plus efficiente de la mémoire.
Cependant, la gestion des conflits de fusion et des liens faux positifs peut être plus complexe dans ce type de système.
Améliorez l'interopérabilité avec les solutions de santé HL7 FHIR : CapMinds FHIR Service
Le compromis du MPI : précision et coût
Si les données sont continuellement agrégées à partir de différentes sources, une stratégie de liaison semble préférable, car il n'est pas nécessaire de résoudre continuellement des conflits de fusion, tandis que les liens faux positifs peuvent simplement être annulés par déliaison.
D'un autre côté, ce système ne traite pas seulement d'un seul dossier patient, et la plupart des interactions portent sur des ensembles de dossiers.
Dans les systèmes réels, il est courant d'utiliser une approche hybride, combinant à la fois la liaison et la fusion. En effet, le problème du compromis entre maintenir l'intégrité des données et permettre des requêtes flexibles d'un côté, et créer une image complète et exacte des données de l'autre est insoluble.
L'hybridation rend l'ensemble du système plus complexe, mais aboutit au résultat souhaité en fin de compte. Par exemple, un système pourrait d'abord lier les dossiers appariés pour créer une relation entre eux, puis fusionner les dossiers liés en un seul dossier consolidé.
Alternativement, un système pourrait d'abord fusionner les dossiers appariés, puis lier les dossiers consolidés résultants.
Le compromis dans le choix entre liaison et fusion dépend des objectifs et des exigences spécifiques du système. Si l'accent est mis sur le maintien de l'intégrité des données et la possibilité de requêtes flexibles, la liaison peut être préférée. Si l'accent est mis sur la création d'une image complète et exacte des données, la fusion peut être préférée.
Pour expérimenter la mise en œuvre d'un Master Patient Index et l'appariement de dossiers, essayez la version de développement gratuite de MDMbox. Elle offre un environnement complet pour tester ces fonctionnalités, fournissant tous les outils nécessaires sans aucune limitation.
Conclusion
Il y a plusieurs points clés à garder à l'esprit lors de la mise en œuvre d'un Master Patient Index dans le cadre de votre stratégie de Master Data Management en santé :
- S'assurer que les données utilisées sont de bonne qualité et intégrité ; sinon, elles doivent être nettoyées et normalisées ;
- Choisir l'algorithme le plus approprié en fonction de toutes les exigences spécifiques de votre projet et de la qualité des données dont vous disposez ;
- Établir le compromis entre la fusion ou la liaison des dossiers, ou créer un système hybride ;
- Traiter le MPI comme une entité au sein d'un programme plus vaste de Master Data Management — les mêmes primitives d'appariement, de fusion et d'audit s'étendent aux prestataires, aux organisations et aux lieux.
Notre MDMbox utilise la méthode probabiliste basée sur l'algorithme Fellegi-Sunter, car elle s'est révélée très efficace pour obtenir des résultats précis et efficients. Cet algorithme a été largement étudié, optimisé pour une utilisation avec des bases de données relationnelles (SQL) et a obtenu d'excellents résultats sur de grands jeux de données.
Dans MDMbox, les opérations d'appariement et de fusion de patients s'exécutent en quelques millisecondes, même à grande échelle. La déduplication en lot est tout aussi efficiente — par exemple, l'identification de tous les candidats en double dans un jeu de données de 5 millions de patients prend environ 20 minutes. Pour un exemple concret, voyez comment nous avons trouvé des milliers de dossiers en double dans le registre NPI en utilisant la même approche.
De plus, MDMbox fournit une interface utilisateur intégrée pour les gestionnaires de données (Data Steward), permettant aux équipes de réviser et de résoudre les conflits de fusion, de gérer les doublons potentiels et de suivre les journaux d'audit complets de fusion et de défusion pour une transparence et un contrôle total. En savoir plus
Auteurs : Nikolai Ryzhikov, DPT chez Health Samurai Ivan Shukshin, ingénieur logiciel principal chez Health Samurai
Voir aussi : Dossiers patients en double dans l'analytique en santé, Fournisseurs MPI et sémantique patient $merge, Données synthétiques en santé et FHIR comme format de stockage de données.