

Ein Master Patient Index (MPI) ist ein Datenbanksystem im Gesundheitswesen, das jeden Patienten über mehrere Datensätze und Quellsysteme hinweg eindeutig identifiziert. Das Akronym MPI bezeichnet speziell das Patientenidentitäts-Subsystem des Master Data Management (MDM) im Gesundheitswesen. Ein MPI konsolidiert doppelte Datensätze, ermöglicht Record Linkage und gibt Leistungserbringern eine einzige, genaue Sicht auf jeden Patienten.
In manchen Kontexten auch als Patient Index oder Healthcare Patient Index bezeichnet, bildet der MPI das Rückgrat patientenzentrierter Datensysteme. Je mehr Informationen Leistungserbringer über einen Patienten haben, desto besser ist die Versorgung, die sie leisten können – jedoch nur, wenn diese Informationen korrekt der richtigen Person zugeordnet sind.
Standardprotokolle wie FHIR, die durch nationale Regulierungen unterstützt werden, erleichtern die Erfassung von Patientendaten aus Laboren, Krankenhäusern, Diagnosezentren usw. Die Frage, ob verschiedene Datensätze zur selben Person gehören oder doppelt vorhandene Daten enthalten, kann jedoch eine Herausforderung darstellen. Dies ist das Kernproblem, das Healthcare Master Data Management (MDM) lösen soll – und der Master Patient Index (MPI) ist sein patientenbezogenes Subsystem, ergänzt durch einen geeigneten Record-Linkage-Algorithmus.
In diesem Artikel besprechen wir:
- Was der Master Patient Index (MPI) & Record Linkage sind und wie sie in das Healthcare Master Data Management eingebettet sind;
- Wie ein MPI implementiert wird und welche Methoden dabei eingesetzt werden können;
- Wie der richtige Record-Linkage-Algorithmus ausgewählt wird.
Was ist ein Master Patient Index (MPI)?
Der Master Patient Index (MPI) ist eine Software, die in Gesundheitsorganisationen eingesetzt wird, um jeden Patienten eindeutig zu identifizieren und dessen mehrere Datensätze zusammenzuführen. Dies trägt dazu bei, sicherzustellen, dass alle Leistungserbringer Zugang zu genauen Informationen über Patienten haben.
Record Linkage ist der Prozess des Abgleichens doppelter Datensätze. Der Matching-Algorithmus (die Methode) ist das Herzstück des Master Patient Index. Er berechnet die Ähnlichkeit zweier Datensätze und entscheidet, ob sie identisch sind.
Hinweis: Wenn Sie nach einem umfassenden Werkzeug zur Verwaltung von Patientendatensätzen suchen, ist der Begriff „Master Patient Index" ein nützliches Suchwort. Wenn Sie mehr daran interessiert sind zu verstehen, wie es funktioniert, lesen Sie einfach weiter und googeln Sie später „Record Linkage".
Wie der MPI in das Healthcare Master Data Management passt
Master Data Management (MDM) im Gesundheitswesen ist die Disziplin, eine einzige, verlässliche Sicht auf die Entitäten aufzubauen, auf die das übrige System angewiesen ist – Patienten, Leistungserbringer, Organisationen, Standorte, Kostenträger. Jede dieser Entitäten hat ihre eigenen Besonderheiten, aber das technische Muster ist dasselbe: Daten aus vielen Quellsystemen einlesen, Datensätze zusammenführen, die auf dieselbe reale Entität verweisen, und Konflikte zu einem Golden Record auflösen, dem nachgelagerte Systeme vertrauen können.
Der Master Patient Index ist der patientenspezifische Teil dieses Bildes. Er ist bei weitem das am häufigsten diskutierte Segment des Healthcare MDM, weil Fehler bei der Patientenidentität am teuersten sind: Ein duplizierter Patientendatensatz fragmentiert eine klinische Geschichte; ein fälschlicherweise zusammengeführter Datensatz erzeugt ein Sicherheitsereignis. Wenn Teams also über „MPI" sprechen, meinen sie fast immer eine Master-Data-Management-Funktion, die auf Patient zugeschnitten ist – dieselbe Matching-, Blocking-, Merge- und Audit-Maschinerie, die auch für jede andere Master-Entität verwendet würde, nur dort eingesetzt, wo die Einsätze am höchsten sind.
Im weiteren Verlauf dieses Artikels betrachten wir, wie diese Maschinerie tatsächlich funktioniert.
Wie ein Master Patient Index funktioniert
Die Implementierung eines Master Patient Index folgt einer spezifischen Pipeline, die aus mehreren wichtigen Schritten besteht:
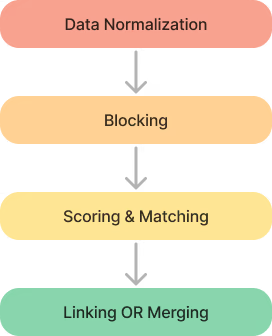
- Datenbereinigung & Normalisierung – Daten bereinigen und ihr Format standardisieren;
- Blocking – Datensätze vorgruppieren, um die Anzahl der Datensatzvergleiche für eine bessere Performance zu reduzieren;
- Scoring & Matching – das „Herzstück" des Prozesses: die Ähnlichkeit von Datensätzen ermitteln und automatisches oder manuelles Matching durchführen;
- Verknüpfen oder Zusammenführen doppelter Datensätze.
Nun wollen wir jeden Schritt genauer betrachten.
Master Patient Index: Datenbereinigung & Normalisierung
Zunächst bereinigen wir die Daten.
Stellen Sie sicher, dass Identifikatoren (wie Adresse, Geschlecht, Sozialversicherungsnummer usw.) einheitlich formatiert sind, um am Ende genauere Ergebnisse zu erzielen. Dies kann durch das Entfernen von Satzzeichen, die Umwandlung in Großbuchstaben und die Standardisierung von Werten erreicht werden.
Terminologien normalisieren: Während Geschlecht in einem Datensatz als „Male/Female" und in einem anderen als „Man/Woman" dargestellt sein kann, sollte es einheitlich kodiert werden.
Wenn ein Wert ungültig ist und nur zur Erfüllung eines Pflichtfelds eingegeben wurde (z. B. „Baby boy" im Vornamensfeld oder „00000000" für eine Sozialversicherungsnummer), wird empfohlen, den Wert auf „NULL" zurückzusetzen, da der Algorithmus empfindlich auf solche Einträge reagieren kann.
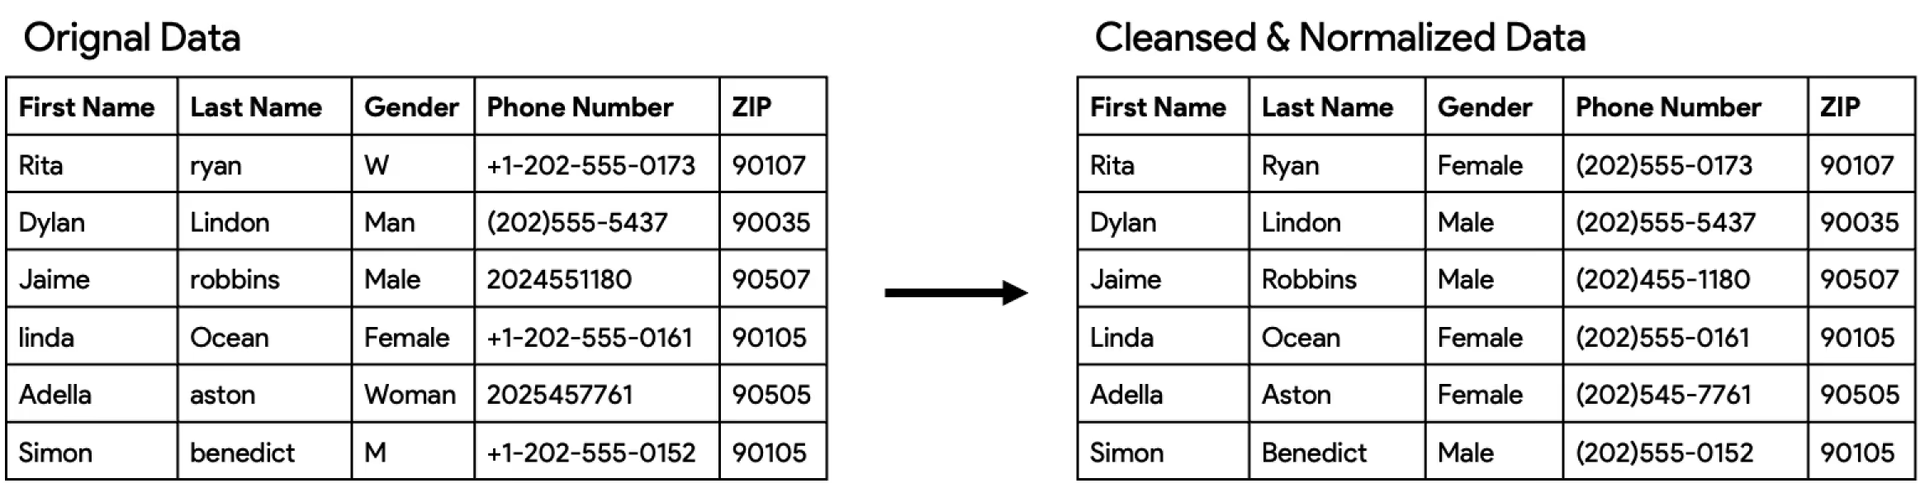
Der ideale Fall tritt auf, wenn Ihre Datenquelle saubere Daten im gleichen Format (gleiche Attributnamen) liefert, aber das ist nicht immer der Fall und in der Regel müssen Sie Ihre Daten in dasselbe Format konvertieren.
Wir empfehlen die Verwendung von HL7 FHIR für standardisierte Datenformate, da wir eine erhebliche Verbreitung von FHIR beobachten und es so aussieht, als würde FHIR in naher Zukunft zur Lingua franca für den Austausch von Gesundheitsdaten werden. Unsere Master Patient Index & Master Data Management-Lösung MDMbox ist auf FHIR aufgebaut.
Master Patient Index: Blocking
Sobald die Daten bereinigt und normalisiert wurden, können wir mit dem Blocking-Prozess beginnen. Wenn ein Master Patient Index eine Million Datensätze enthält, würde ein einfacher Vergleich aller Datensätze eine Billion Vergleiche erfordern – diese Zahl lässt sich jedoch erheblich reduzieren.
In der Regel wird der Datensatz durch eine Reihe von Filtern geführt, wobei jedes Mal ein anderes Attribut oder eine andere Methode verwendet wird, um mögliche Übereinstimmungen zu identifizieren. Es gibt jedoch einen Kompromiss zwischen Performance und Genauigkeit, und es ist wichtig, den richtigen Schlüssel für das Blocking zu wählen.
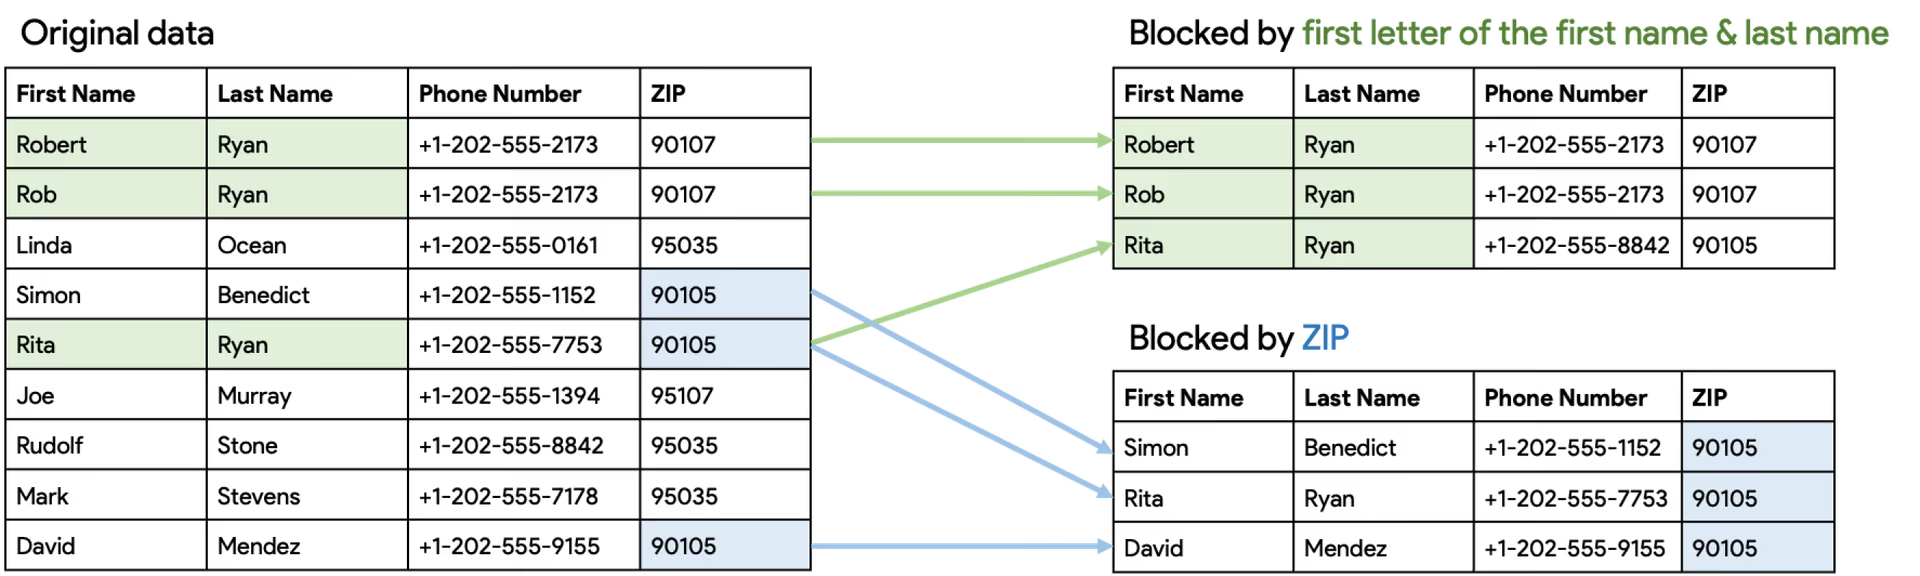
Blocking erfolgt typischerweise durch die Aufteilung der Datensätze in kleinere Gruppen – sogenannte „Blöcke" – anhand bestimmter Kriterien (Filter), z. B. unter Verwendung schwacher Ähnlichkeit (wie Vorname, Geschlecht, Geburtsjahr, Postleitzahl usw.).
Wie im folgenden Beispielschema zu sehen ist, kann eine Blocking-Operation Kandidatenblöcke anhand des Attributs Nachname und des ersten Buchstabens des Vornamens erzeugen, oder sie kann Blöcke anhand anderer Attribute wie Telefonnummer oder Postleitzahl bilden:
Das Matching erfolgt dann innerhalb des Blocks oder zwischen zwei Blöcken desselben Attributs:
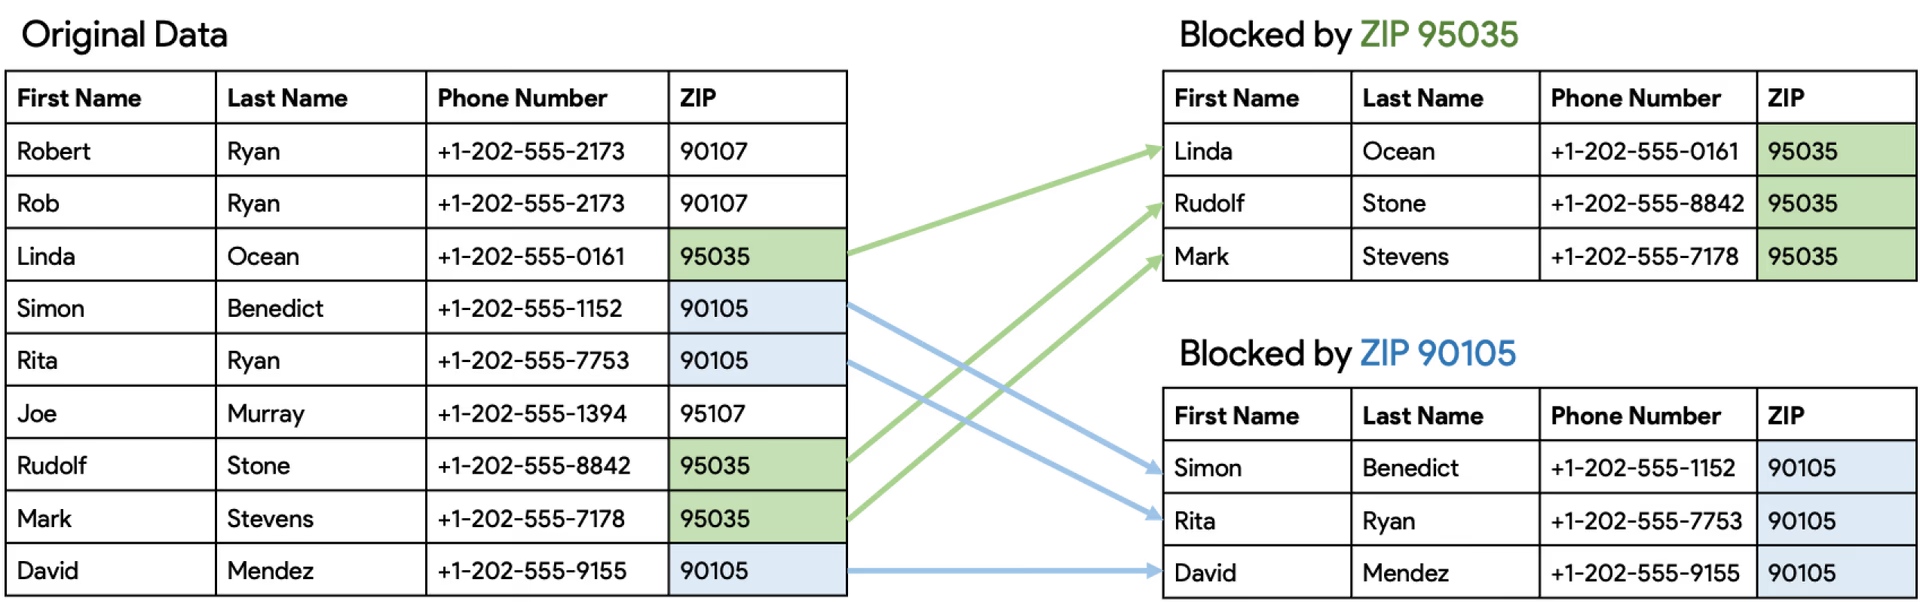
Es ist erwähnenswert, dass verschiedene Durchläufe dieser Operation unterschiedliche echte Übereinstimmungen aufdecken können, sodass die Kombination der Ergebnisse potenziell einen Großteil der echten Übereinstimmungen aufdecken kann.
Das Ziel ist es, die Anzahl der Kandidaten zu minimieren. Daher sollten die Richtlinien sein:
- Breit genug, um alle relevanten Datensätze innerhalb desselben Blocks zu erfassen;
- Spezifisch genug, um einen effizienten Vergleich der Kandidaten in einem angemessenen Zeitrahmen zu ermöglichen.
Master Patient Index: Scoring & Matching
Das „Herzstück" des Master Patient Index ist der Scoring- & Matching-Prozess. In diesem Schritt ist es entscheidend zu bestimmen, ob zwei Datensätze wahrscheinlich auf dieselbe Person verweisen. Algorithmen können Datensätze in zwei Gruppen einteilen – Match oder Not Match – oder in eine dritte Gruppe, Possible Match, bei der die Entscheidung an Menschen delegiert werden kann.
Matching kann mit verschiedenen Methoden durchgeführt werden:
- Deterministische (regelbasierte) Methode – verwendet einen Regelsatz (z. B. Sozialversicherungsnummer, Geburtsdatum und Nachname stimmen überein) und wird auch als Exact-Match-Logik bezeichnet. Deterministische Regeln können mit einem hohen Maß an Spezifität gestaltet werden;
- Probabilistische (scoringbasierte oder Fellegi-Sunter) Methode – diese Methode verknüpft die Datensätze, wenn die Summe aller gewichteten Übereinstimmungen die Abweichungen überwiegt.
Sie können diese Tabelle verwenden, um die Methoden schnell und einfach zu vergleichen:
| Methode | Vorteile | Nachteile |
|---|---|---|
| Deterministische (regelbasierte) Methode Verwendet einen Regelsatz (z. B. Sozialversicherungsnummer, Geburtsdatum und Nachname stimmen überein), auch als Exact-Match-Logik bezeichnet. Deterministische Regeln können mit einem hohen Maß an Spezifität gestaltet werden | Einfach zu implementieren Einfach zu schreiben und die einfachen Regeln zu verstehen | Begrenzte Genauigkeit oder es sind komplizierte Erweiterungen erforderlich, um sie zu verbessern Schwer, einen Regelsatz für ein genaues Matching zu pflegen Sehr empfindlich gegenüber Datenqualität Schwer effizient für große Datensätze zu implementieren Es gibt keine Möglichkeit, die Qualität des Algorithmus zu quantifizieren |
| Probabilistische (scoringbasierte oder Fellegi-Sunter) Methode Diese Methode verknüpft die Datensätze, wenn die Summe aller gewichteten Übereinstimmungen die Abweichungen überwiegt | Verwendet alle verfügbaren Datenpunkte für eine Entscheidung (Match oder Not Match). Verarbeitet fehlende oder ungültige Daten Kann aus vorhandenen und neuen Datenstatistiken lernen Die Qualität des Algorithmus (Genauigkeit & Sensitivität) kann numerisch geschätzt werden Skaliert gut mit Blocking für große Datensätze Erfolgreich für Populationsanalysen in vielen Projekten eingesetzt | Erfordert Konfiguration und Abstimmung durch Experten |
MDMbox verwendet die Probabilistische Methode (auf dem Fellegi-Sunter-Algorithmus basierendes Modell), die eine Art Bayes'schen Klassifikator darstellt, und vergleicht die Werte bestimmter Attribute wie Vorname, Geburtsdatum oder Sozialversicherungsnummer. Wenn die Attribute übereinstimmen, erhöht sich die Matching-Wahrscheinlichkeit; wenn die Attribute nicht übereinstimmen, sinkt die Matching-Wahrscheinlichkeit.
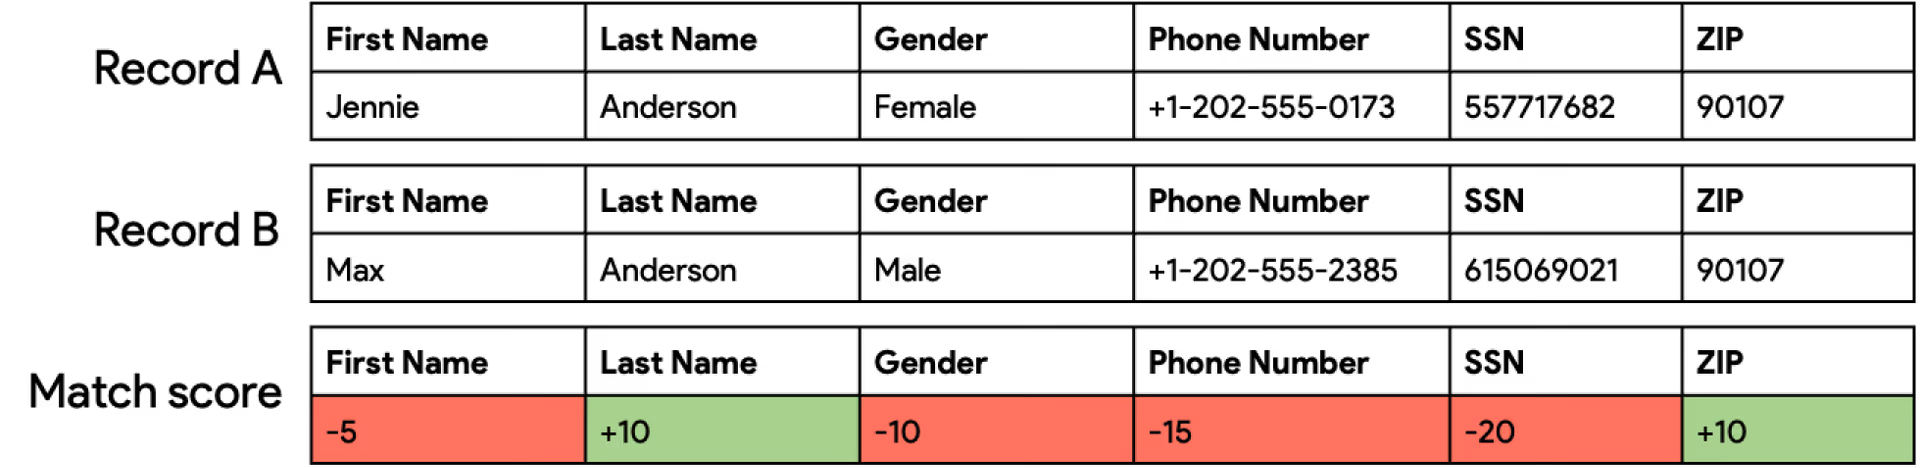
Wir verwenden also ein System, das uns hilft zu entscheiden, wie wahrscheinlich es ist, dass zwei Datensätze identisch sind. Wir beginnen damit, abzuschätzen, wie wahrscheinlich es ist, dass zwei zufällig ausgewählte Datensätze übereinstimmen. Dann vergleichen wir die Datensätze, um festzustellen, ob sie Gemeinsamkeiten aufweisen, wie dasselbe Geburtsdatum, dieselbe Sozialversicherungsnummer oder dieselbe Telefonnummer.
Hier ist also eine kurze und einfache Erklärung, wie der Algorithmus funktioniert: Er vergleicht Datensätze und bewertet die Belege genau, sodass wir die Wahrscheinlichkeit einer Übereinstimmung bestimmen können:
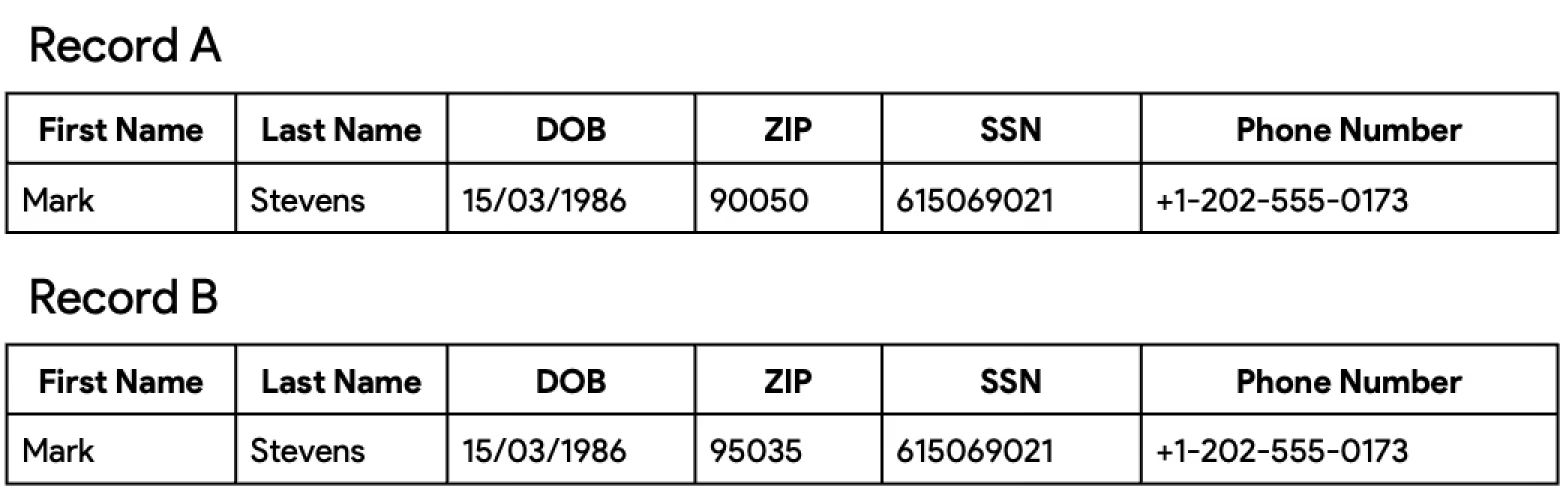
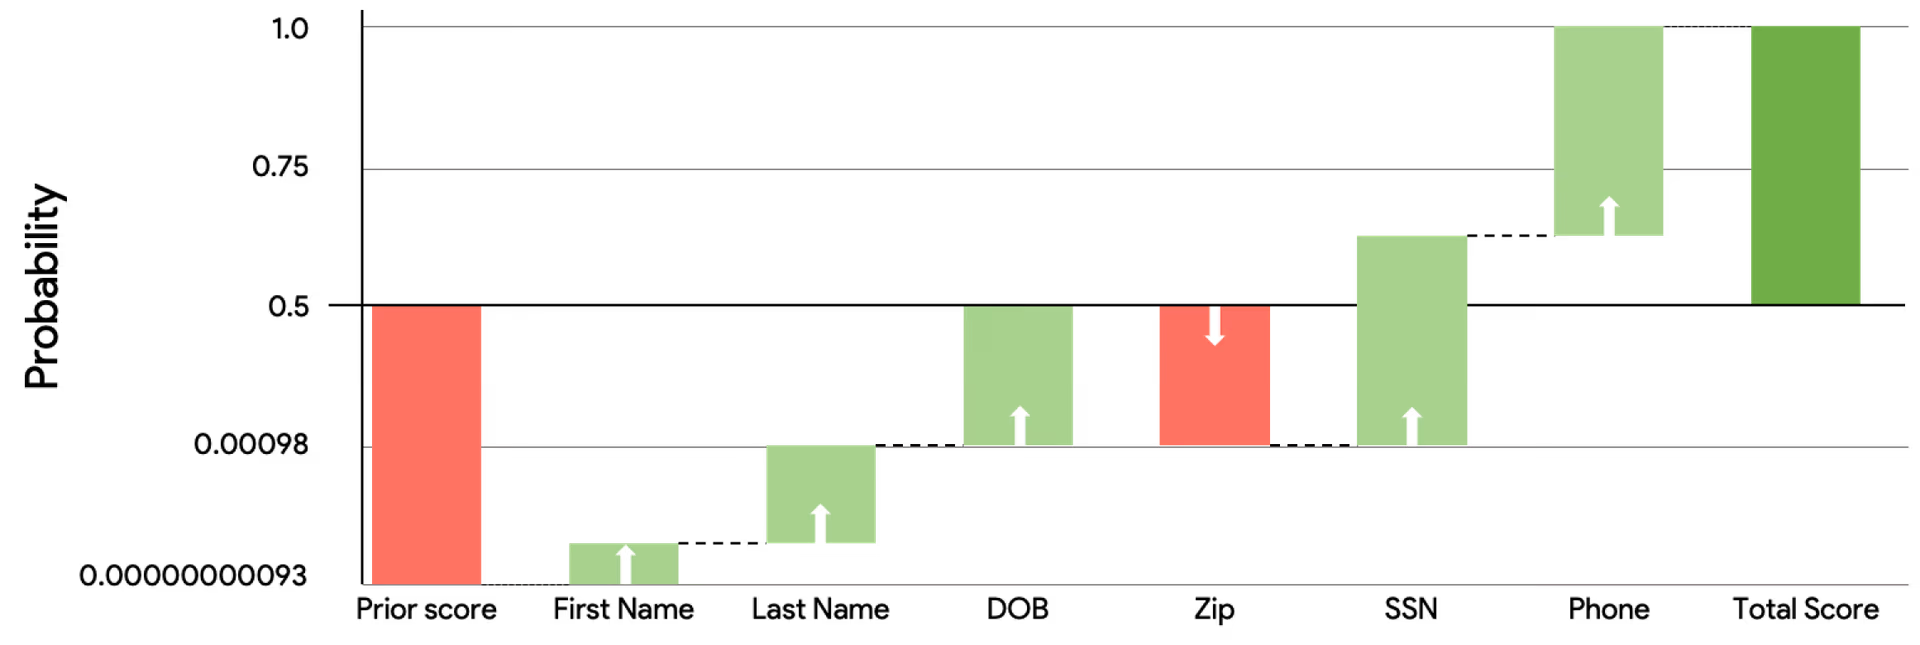
- Spalten mit einer größeren Anzahl eindeutiger Werte, wie Geburtsdatum, Sozialversicherungsnummer oder Telefonnummer, stellen mit größerer Wahrscheinlichkeit eine starke Übereinstimmung fest, da es unwahrscheinlich ist, dass diese Werte in zwei zufällig ausgewählten Datensätzen zufällig übereinstimmen würden.
- Wenn eine Spalte nicht übereinstimmt, ist dies in der Regel ein Hinweis gegen eine Übereinstimmung. Wir müssen jedoch einräumen, dass dieser Hinweis in Fällen, in denen externe Faktoren wie eine Namensänderung aufgrund einer Heirat, ein Umzug, der dazu führt, dass der Patient eine andere Postleitzahl hat, oder ein einfacher Tippfehler bei der Dateneingabe zu einer Nichtübereinstimmung in der Spalte führen können, möglicherweise nicht vollständig zuverlässig ist.
Wenn dieser gesamte Evidenz-Score einen konfigurierbaren Schwellenwert, den sogenannten Trennwert, erreicht oder überschreitet, gelten die Datensätze als übereinstimmend und können zusammengeführt werden. Wenn der Score unter dem Schwellenwert liegt, gelten die Datensätze als verschiedene Personen und werden im Master Patient Index nicht zusammengeführt.
Eine gängige Praxis besteht darin, die Verteilung der Scores zu untersuchen und eine Ähnlichkeitsmethode zu wählen, die zu einer gewünschten Rate an falsch positiven oder falsch negativen Ergebnissen führt. Dies kann dazu beitragen, das Bedürfnis nach Genauigkeit mit dem Bedürfnis, den Arbeitsaufwand für menschliche Prüfer zu minimieren, in Einklang zu bringen. Eine praktische Anleitung zu dieser Kalibrierung finden Sie in unserem Leitfaden zur Konfiguration und Abstimmung eines Patientenabgleichsmodells.
Starten Sie mit dem Aidbox FHIR Server für Datenspeicherung, Integrationen, Healthcare-Analysen und mehr, oder beauftragen Sie unser Team, um Ihre Softwareentwicklungsanforderungen zu unterstützen.
Den Matching-Algorithmus auswählen
Als Standardwahl scheint Fellegi-Sunter die am besten geeignete Option zu sein. Es erfordert einen Experten für die Einrichtung und Konfiguration, kann jedoch ein gutes Ergebnis liefern.
Wenn Sie weniger vertrauenswürdige Datenquellen mit engen Beziehungen haben, reichen einfache deterministische Regeln aus, aber es gibt keine Möglichkeit, deren Genauigkeit zu bewerten.
Verknüpfen oder Zusammenführen?
Nachdem die Datensätze abgeglichen wurden, ist es wichtig zu entscheiden, ob Sie die Datensätze verknüpfen oder zusammenführen sollten.
- Das Verknüpfen der Datensätze bedeutet, dass wir alle doppelten Datensätze so belassen, wie sie sind, sie jedoch miteinander verknüpfen. Wenn Sie für verschiedene Duplikate unterschiedliche Quellen haben, gibt es kein Problem beim Aktualisieren der Datensätze.
Dies ist in Fällen nützlich, in denen Daten kontinuierlich aus verschiedenen Quellen aggregiert werden, da der Master Patient Index so die Beziehungen zwischen Datensätzen verfolgen kann, ohne kontinuierlich Merge-Konflikte auflösen zu müssen.
- Das Zusammenführen der Datensätze bedeutet, die Datensätze zu einem einzigen, hybriden Datensatz zu kombinieren.
Dies beinhaltet die Zusammenführung der Daten aus mehreren Datensätzen zu einem einzigen Datensatz, der alle relevanten Informationen über einen Patienten enthält. Im Vergleich zur Verknüpfung ermöglicht das Zusammenführen einen einfacheren und schnelleren Datenabruf sowie eine effizientere Speichernutzung.
Es kann jedoch komplexer sein, Merge-Konflikte und falsch positive Verknüpfungen in diesem Systemtyp zu verwalten.
Verbessern Sie die Interoperabilität mit HL7 FHIR-Gesundheitslösungen: CapMinds FHIR Service
Der MPI-Kompromiss: Genauigkeit vs. Kosten
Wenn Daten kontinuierlich aus verschiedenen Quellen aggregiert werden, erscheint eine Verknüpfungsstrategie vorzuziehen, da keine kontinuierliche Auflösung von Merge-Konflikten erforderlich ist, während falsch positive Verknüpfungen einfach durch Trennen rückgängig gemacht werden können.
Andererseits hat dieses System es nicht nur mit einem einzelnen Patientendatensatz zu tun, und die meisten Interaktionen betreffen Datensatzmengen.
In realen Systemen ist es üblich, einen Hybridansatz zu verwenden, der sowohl Verknüpfen als auch Zusammenführen kombiniert. Dies liegt daran, dass das Problem des Kompromisses zwischen dem Erhalt der Datenintegrität & der Ermöglichung flexibler Abfragen einerseits und dem Erstellen eines vollständigen & genauen Datenbilds andererseits unlösbar ist.
Die Hybridisierung macht das Gesamtsystem komplexer, führt aber letztendlich zum gewünschten Ergebnis. Beispielsweise könnte ein System zunächst übereinstimmende Datensätze verknüpfen, um eine Beziehung zwischen ihnen herzustellen, und dann die verknüpften Datensätze zu einem einzigen, konsolidierten Datensatz zusammenführen.
Alternativ könnte ein System zunächst übereinstimmende Datensätze zusammenführen und dann die resultierenden konsolidierten Datensätze verknüpfen.
Der Kompromiss bei der Wahl zwischen Verknüpfen und Zusammenführen hängt von den spezifischen Zielen und Anforderungen des Systems ab. Wenn der Fokus auf dem Erhalt der Datenintegrität und der Ermöglichung flexibler Abfragen liegt, kann Verknüpfen bevorzugt werden. Wenn der Fokus auf dem Erstellen eines vollständigen und genauen Datenbilds liegt, kann Zusammenführen bevorzugt werden.
Um die Implementierung eines Master Patient Index und des Datensatzabgleichs auszuprobieren, testen Sie die kostenlose Entwicklungsversion von MDMbox. Sie bietet eine vollständige Umgebung zum Testen dieser Funktionen und stellt alle notwendigen Werkzeuge ohne Einschränkungen bereit.
Fazit
Bei der Implementierung eines Master Patient Index als Teil Ihrer Healthcare-Master-Data-Management-Strategie sind mehrere wichtige Punkte zu beachten:
- Stellen Sie sicher, dass die verwendeten Daten von guter Qualität und Integrität sind, andernfalls sollten sie bereinigt und normalisiert werden;
- Wählen Sie den am besten geeigneten Algorithmus basierend auf allen spezifischen Projektanforderungen und der Qualität Ihrer Daten;
- Legen Sie den Kompromiss zwischen dem Zusammenführen oder Verknüpfen von Datensätzen fest oder entwickeln Sie ein Hybridsystem;
- Behandeln Sie den MPI als eine Entität innerhalb eines umfassenderen Master-Data-Management-Programms – dieselben Matching-, Merge- und Audit-Grundbausteine gelten auch für Leistungserbringer, Organisationen und Standorte.
Unser MDMbox verwendet die probabilistische Methode basierend auf dem Fellegi-Sunter-Algorithmus, da diese sich als äußerst effektiv bei der Erzielung genauer und effizienter Ergebnisse erwiesen hat. Dieser Algorithmus wurde umfassend untersucht, für die Verwendung mit relationalen Datenbanken (SQL) optimiert und hat bei großen Datensätzen außergewöhnlich gut abgeschnitten.
In MDMbox werden Patientenabgleichs- und Zusammenführungsoperationen in Millisekunden ausgeführt, selbst in großem Maßstab. Die Bulk-Deduplizierung ist ebenso effizient – beispielsweise dauert die Identifizierung aller Duplikatkandidaten in einem Datensatz mit 5 Millionen Patienten ~20 Minuten. Ein reales Beispiel finden Sie in unserem Bericht, wie wir Tausende von Duplikatdatensätzen im NPI-Register mit demselben Ansatz gefunden haben.
Darüber hinaus bietet MDMbox eine integrierte Data-Steward-Benutzeroberfläche, die es Teams ermöglicht, Merge-Konflikte zu überprüfen und zu lösen, potenzielle Duplikate zu verwalten und vollständige Merge- und Unmerge-Audit-Protokolle für vollständige Transparenz und Kontrolle zu verfolgen. Mehr erfahren
Autoren: Nikolai Ryzhikov, CTO bei Health Samurai Ivan Shukshin, Lead Software Engineer bei Health Samurai
Siehe auch: Doppelte Patientendatensätze in der Healthcare-Analyse, MPI-Anbieter und Patienten-$merge-Semantik, Synthetische Daten im Gesundheitswesen und FHIR als Datenspeicherformat.