

Démonstration de l'implémentation ELT pour PostgreSQL à l'aide d'Aidbox, du ViewDefinition Builder libre et de Grafana.
Regardons les choses en face : FHIR s'est solidement imposé, et des quantités croissantes de données de santé sont désormais stockées dans ce format. Mais quelle est la façon la plus efficace d'en tirer des informations utiles ?
Dans cet article de blogue, nous verrons comment combler le fossé entre FHIR et SQL grâce à la nouvelle spécification SQL on FHIR v2, qui rend les données FHIR non seulement interopérables, mais aussi interrogeables et analysables.
Au fil de votre lecture, vous découvrirez :
- Qu'est-ce que SQL on FHIR ?
- Comment l'utiliser en pratique ?
- Comment cette technologie va-t-elle évoluer ?
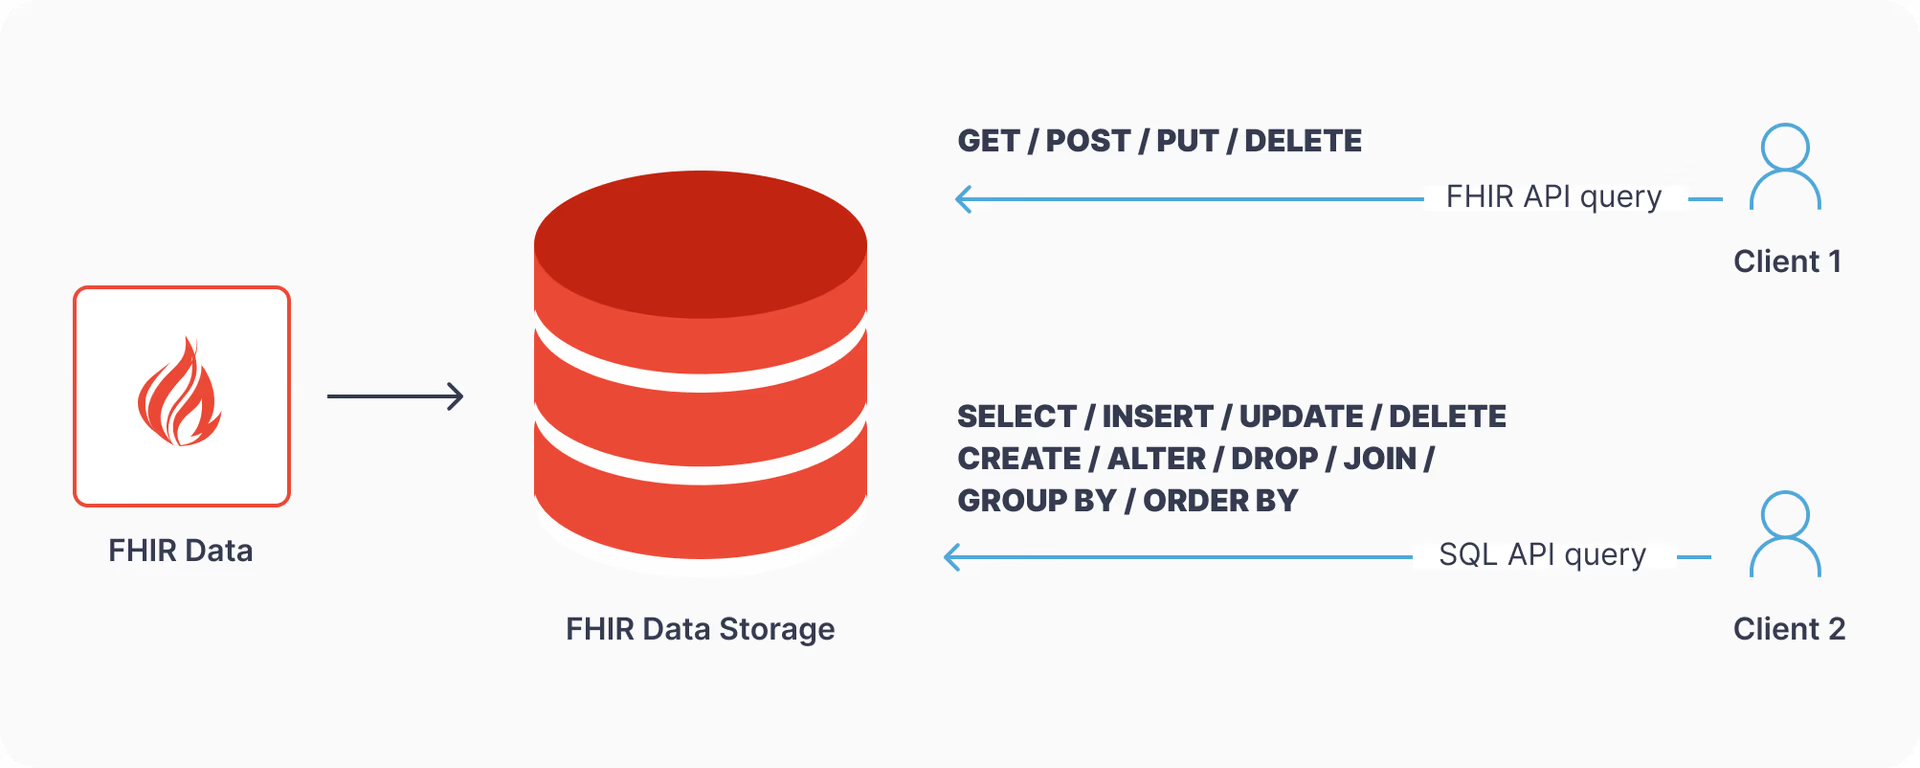
Pourquoi SQL on FHIR ?
FHIR est fourni avec une API de recherche intégrée, mais celle-ci ne suffit pas pour effectuer des requêtes avancées sur les données FHIR. Il lui manque des fonctionnalités essentielles telles que les agrégations, les jointures et d'autres outils de base de données dont vous pourriez avoir besoin.
Le principal défi réside dans le fait que les données FHIR sont imbriquées, ce qui s'écarte de l'approche traditionnelle des bases de données relationnelles à plat. Cette différence rend difficile l'exécution directe de requêtes SQL standard. On pourrait comparer cela à essayer de faire entrer une cheville carrée dans un trou rond.
Il existe bien sûr des technologies de bases de données avancées comme JSONB dans PostgreSQL ou Parquet dans Spark SQL, qui peuvent gérer des structures de données imbriquées. Cependant, les utilisateurs comme les outils sont habitués à travailler avec des tables à plat, traditionnelles en SQL.
Pour contourner ce problème, les développeurs peuvent avoir besoin de créer des vues aplaties des données ou d'utiliser des fonctionnalités spécifiques de bases de données prenant en charge les structures de données imbriquées.
C'est là qu'intervient SQL on FHIR.
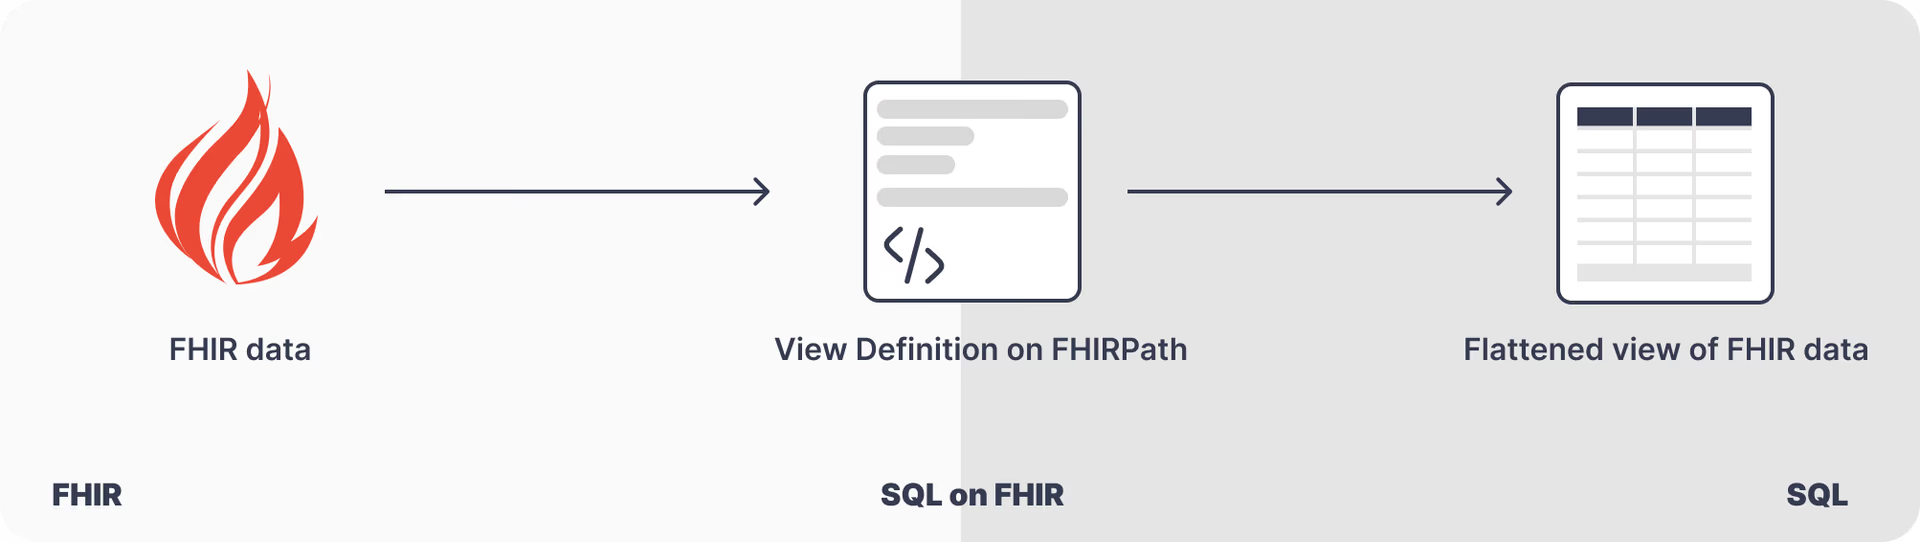
Unir deux mondes pour libérer les données FHIR
La spécification SQL on FHIR propose de définir des vues aplaties des données FHIR de manière standardisée afin de les rendre portables d'un système à l'autre. Cela signifie que vous pouvez facilement exécuter des requêtes SQL standard sur ces vues aplaties. En termes simples, cela libère les données pour l'écosystème SQL, à la manière d'une boîte à outils qui fonctionne aussi bien pour les chevilles rondes que carrées.
Le moteur SQL on FHIR dans Aidbox est actuellement en prévisualisation, mais disponible pour les tests et les retours. En savoir plus
Qu'est-ce qu'une vue aplatie ?
Dans le contexte SQL, une vue aplatie est une table qui présente les données dans une structure simplifiée à couche unique. Les développeurs et les ingénieurs de données peuvent définir des vues aplaties à l'aide d'un sous-ensemble d'expressions FHIRPath standardisées. Cela permet aux utilisateurs d'obtenir les données dans un format qui leur est plus familier.
Utilisez notre ViewDefinition Builder en ligne et gratuit pour convertir des données FHIR stockées en représentation JSON en un format tabulaire et aplati, pratique pour l'analyse de données. Accéder au ViewDefinition Builder
Comme nous l'avons mentionné, les données FHIR imbriquées sont organisées en structure hiérarchique, où des éléments d'information sont contenus dans d'autres éléments, créant ainsi des couches de données liées entre elles.
Voici comment une ressource Patient est structurée dans FHIR :
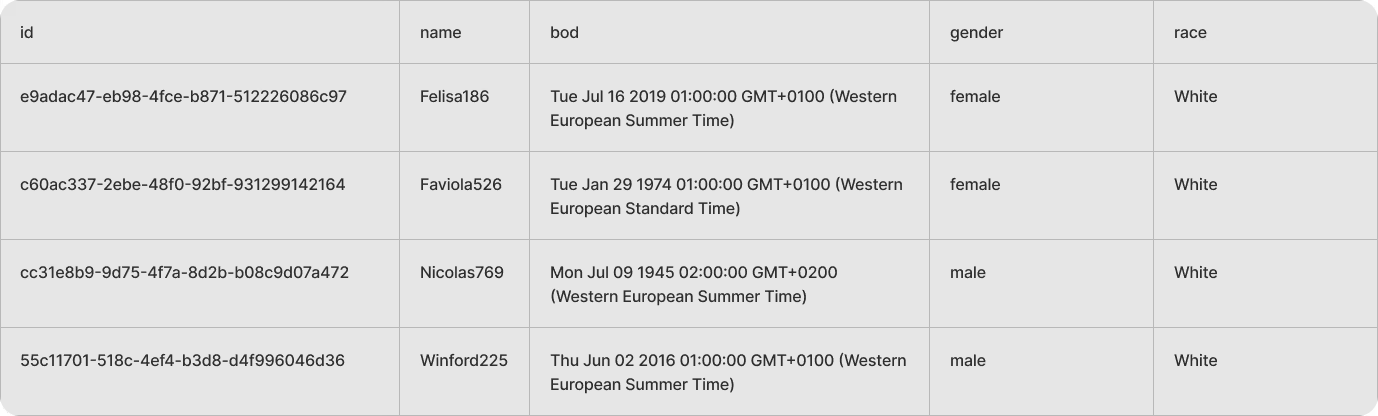
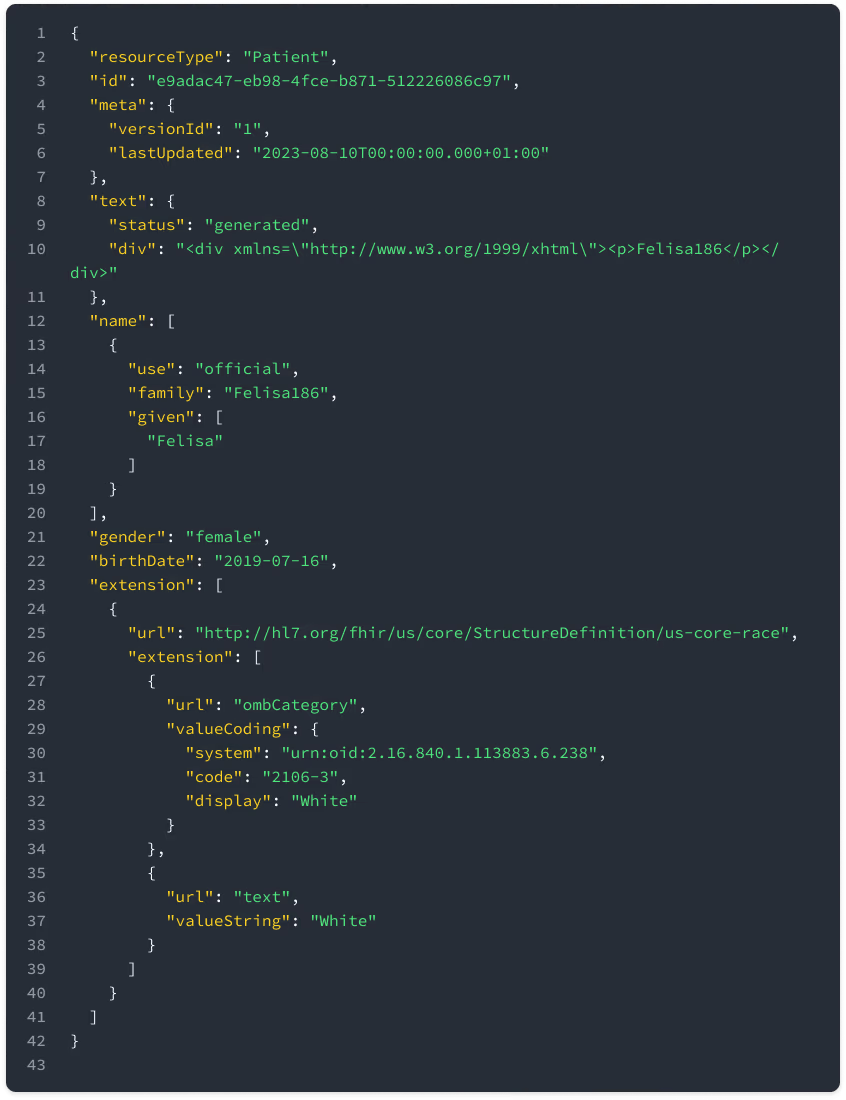 Voyons comment « traduire » des données FHIR complexes en format tabulaire. Pour cela, nous devons créer une View Definition aplatie pour une ressource Patient. Dans notre exemple, la vue contiendra les paramètres suivants : identifiant du patient, date de naissance, sexe, race et nom.
- Précisez le type de ressource à aplatir dans la ligne « from ».
- Utilisez la ligne « select » pour définir les colonnes ainsi que les expressions d'extraction FHIRPath associées.
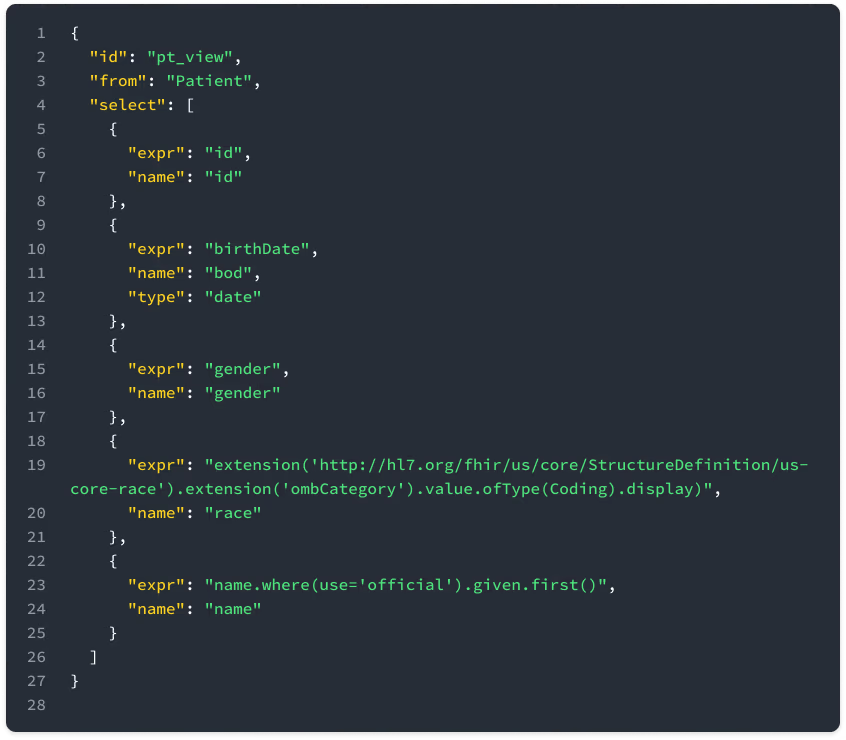 On obtiendra ainsi la table à plat suivante :
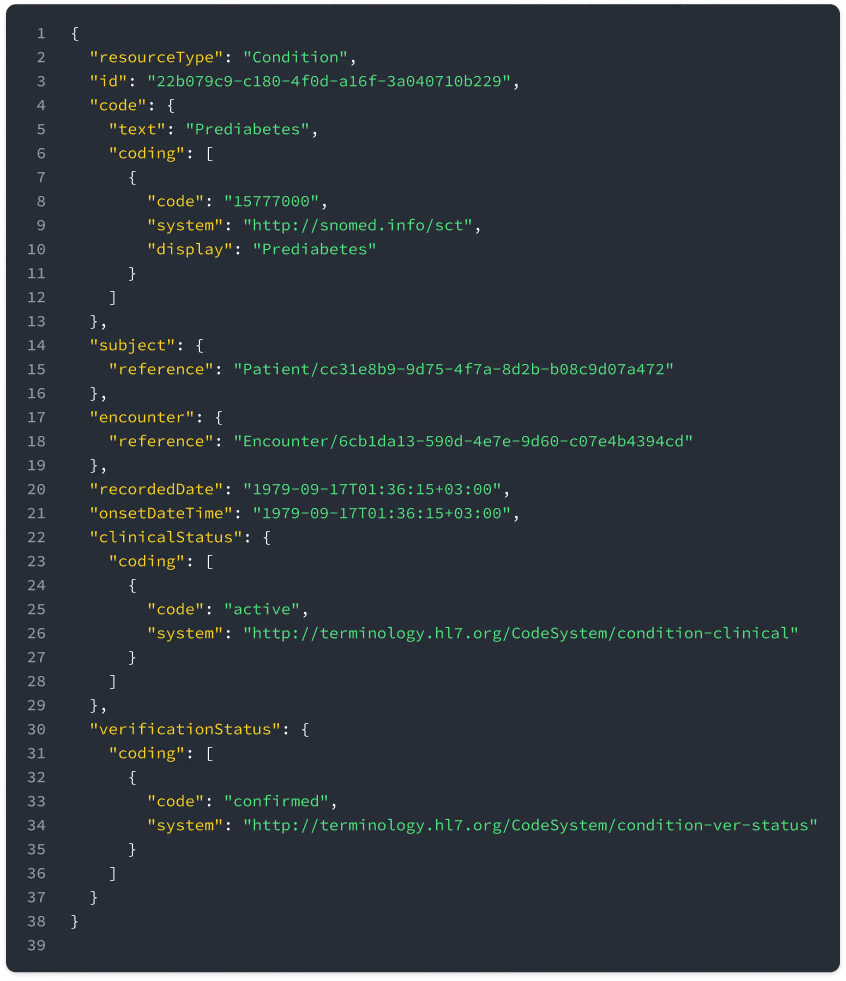
 Prenons maintenant une autre ressource FHIR — Condition :
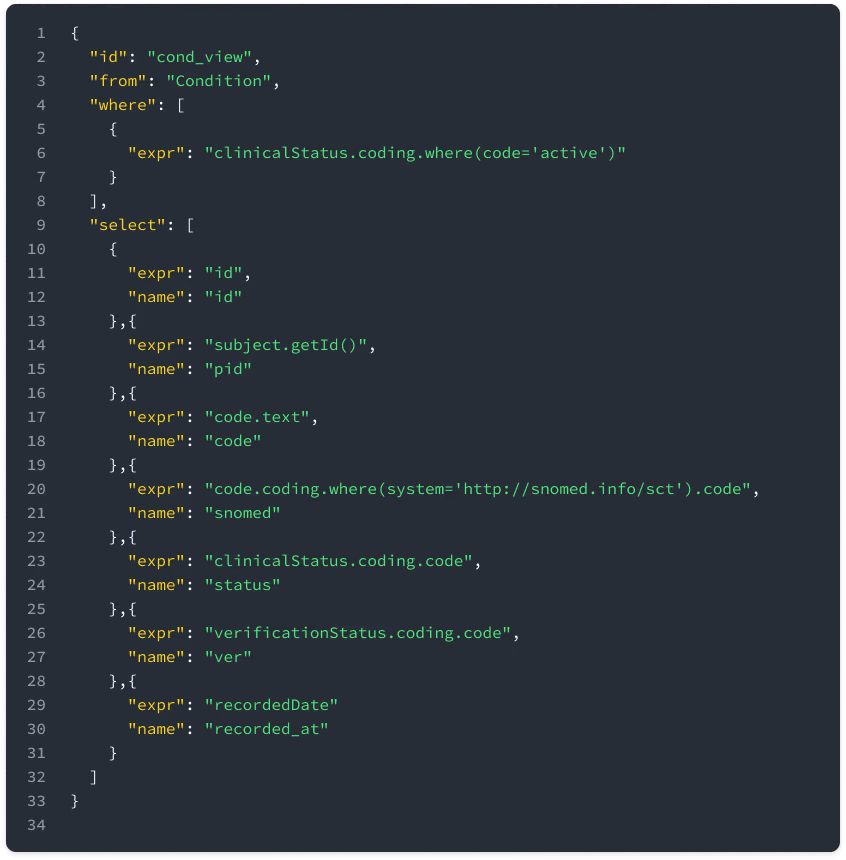
 Aplatissons la ressource Condition de la même façon que nous l'avons fait avec la ressource Patient. La vue contiendra les paramètres suivants : identifiant, identifiant du patient, code, statut, statut de vérification et date d'enregistrement :
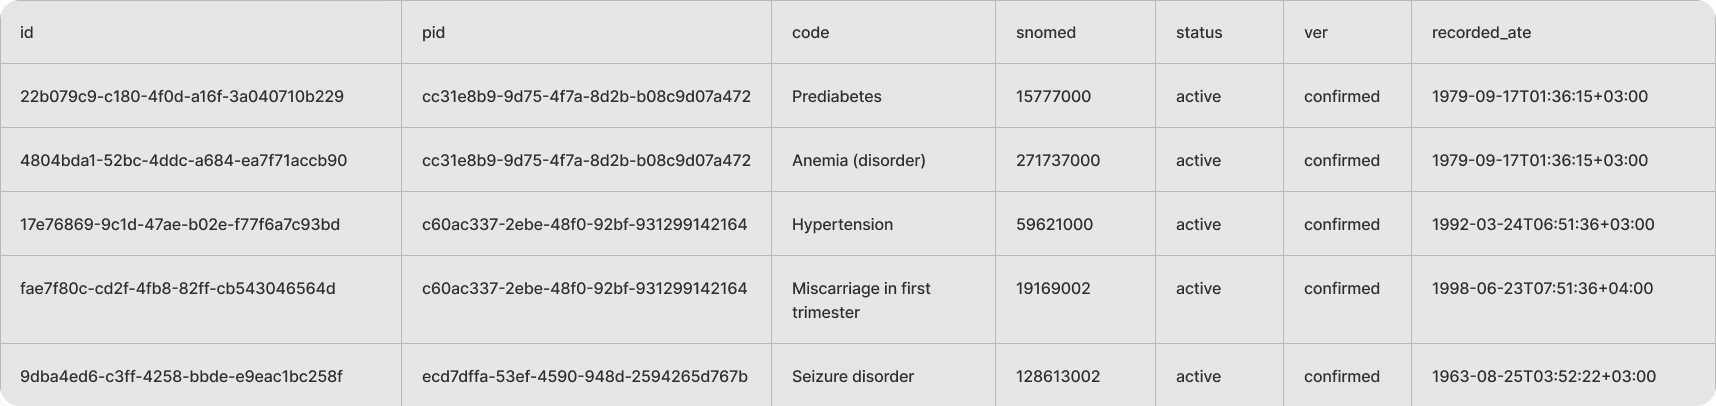
 On obtiendra ainsi la table à plat suivante :
Commencez avec le serveur FHIR Aidbox pour le stockage de données, les intégrations, l'analytique en santé et bien plus encore, ou faites appel à notre équipe pour soutenir vos besoins en développement logiciel.
Données SQL on FHIR standardisées
Une fois que nous disposons de tables à plat, nous pouvons exécuter des requêtes complexes permettant de joindre, filtrer, trier et agréger les données de diverses façons. Vous pouvez également utiliser des sous-requêtes, des fonctions de fenêtrage et d'autres fonctionnalités avancées pour extraire exactement l'information dont vous avez besoin.
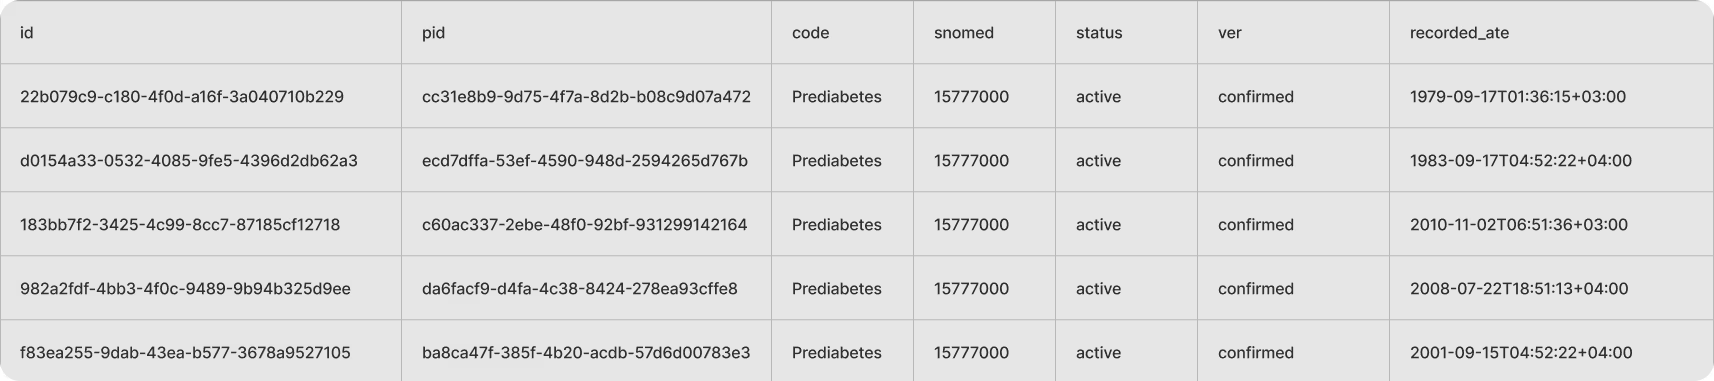
Par exemple, utilisons la vue Condition aplatie précédemment et trouvons tous les patients présentant un état de prédiabète à l'aide d'une simple requête SQL :
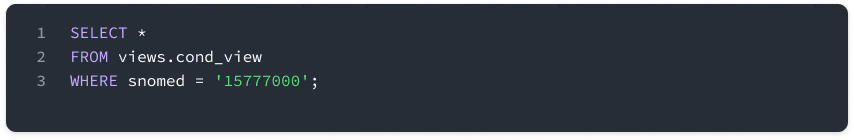 On obtiendra ainsi la table à plat suivante :
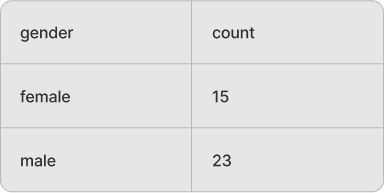
 Nous allons maintenant utiliser à la fois les vues Patient et Condition pour obtenir encore plus d'informations. Comptons combien d'hommes et de femmes présentent un état de prédiabète :
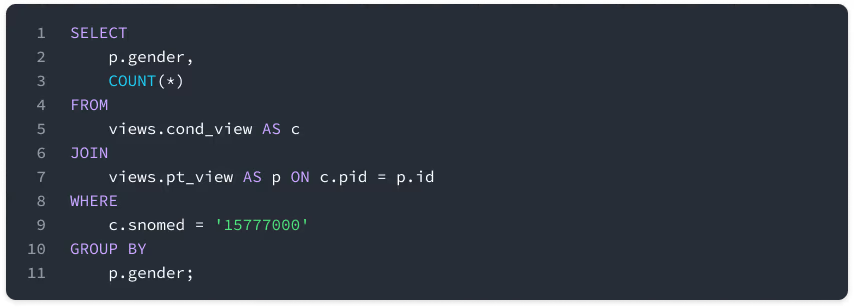 Voici ce que nous obtenons :
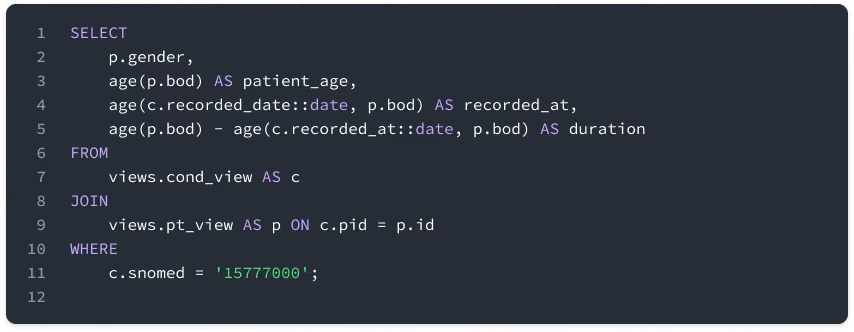
 Trouvons maintenant la durée de l'état :
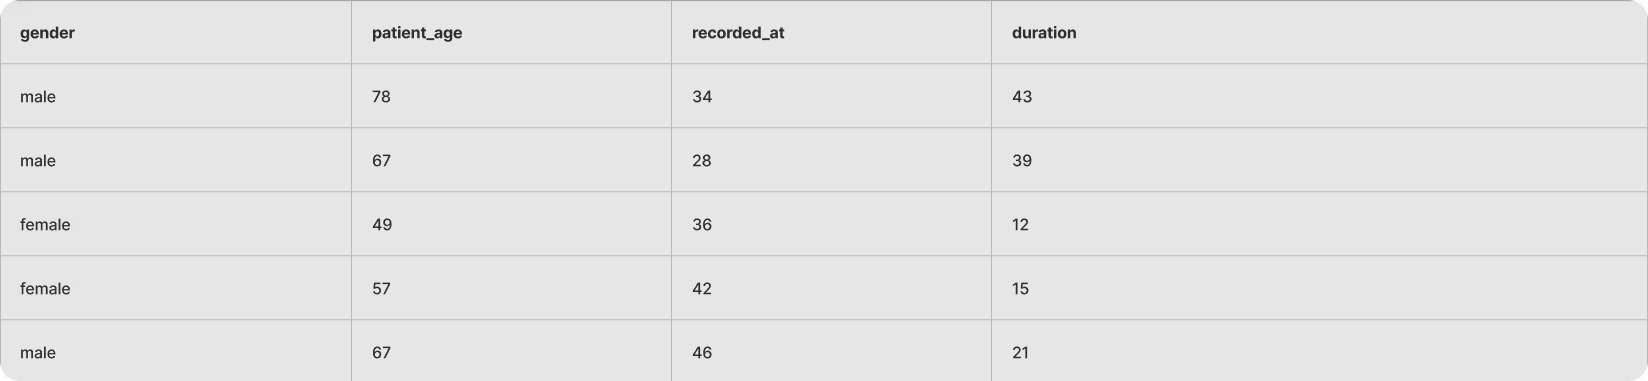
 La table à plat résultante se présente comme suit :
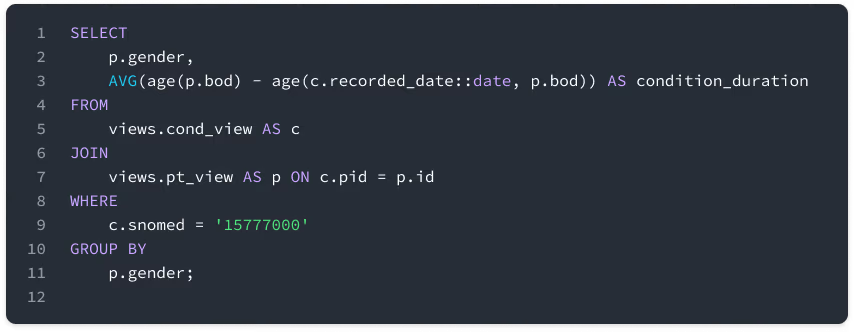
 Trouvons maintenant la durée moyenne du prédiabète chez les hommes et les femmes :
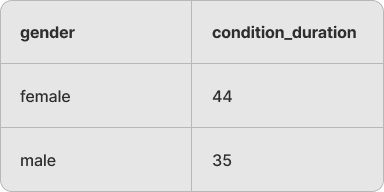
 On obtient ainsi la durée moyenne de l'état pour chaque sexe :
En résumé
SQL on FHIR est une approche puissante qui allie la puissance de SQL et de FHIR, vous permettant de travailler avec des données de santé complexes stockées dans des ressources FHIR tout en utilisant les outils et cadres de requêtes SQL familiers.
Voici un bref résumé des avantages :
- Décisions éclairées : Excellente capacité à extraire des informations pertinentes à partir de jeux de données FHIR complexes.
- Familiarité : Si vous connaissez SQL, vous vous y retrouverez facilement.
- Portabilité : SQL on FHIR utilise FHIRPath pour définir des vues utilisables dans différents systèmes. La communauté FHIR peut définir des vues aplaties et des requêtes exécutables dans tout écosystème basé sur SQL.
Dans l'ensemble, SQL on FHIR comble le fossé entre les données FHIR imbriquées et SQL, offrant une façon simplifiée de gérer et d'utiliser efficacement les données de santé.
Avertissement
Il est important de noter que l'utilisation de SQL on FHIR ne remplace pas le besoin des API FHIR, qui sont essentielles pour l'échange de données entre les systèmes de santé et pour la mise en œuvre des normes d'interopérabilité. SQL on FHIR complète ces capacités en offrant un moyen d'interagir plus efficacement avec les données de santé au format FHIR à des fins analytiques, de recherche et de production de rapports. C'est comme disposer d'une clé universelle pouvant ouvrir de nombreuses portes, facilitant ainsi le travail avec les données FHIR dans différentes technologies.
Pour explorer comment SQL on FHIR peut être appliqué à vos projets, envisagez d'utiliser la version gratuite d'Aidbox. Elle offre un environnement complet pour tester et expérimenter ces capacités, fournissant tous les outils nécessaires sans aucune limitation de fonctionnalités.
Dans un avenir proche
Le projet de spécification SQL on FHIR sera présenté en septembre 2023 au HL7 FHIR Connectathon 34 à Phoenix, en Arizona.
SQL on FHIR v2 est une initiative ouverte et accueille la participation des parties intéressées. Joignez-vous au groupe de travail SQL on FHIR, participez aux discussions et contribuez au développement de cette solution.
- Lire la spécification SQL on FHIR v2
- Participer à la discussion sur GitHub
- Poser vos questions dans le clavardage Zulip
- Visionner sur YouTube
Pour connaître l'état actuel de la norme — ViewDefinition, SQLView/SQLQuery et l'API standard run/export/materialize — consultez l'analytique interopérable avec SQL on FHIR.
Health Samurai pilote activement le groupe de travail SQL on FHIR, qui compte également parmi ses membres Google, CSIRO, Microsoft, Philips, NCQA, CQLab, Center Square Solutions et Vermonster. Le groupe de travail se concentre sur les premières implémentations afin de bâtir une solution standardisée sans enfermement propriétaire.
Le moteur SQL on FHIR de Health Samurai est disponible en prévisualisation et pour les tests. Si vous avez des questions ou des cas d'utilisation précis en tête, n'hésitez pas à les partager. Réservez une rencontre pour le voir en action.