Un nom mal orthographié ou une ancienne adresse peut dissimuler un dossier Patient en doublon. Le Générateur de modèles dans MDMbox 2610.0 apprend les paramètres de jumelage à partir de vos données FHIR Patient, sans paires d'entraînement étiquetées. Vous choisissez les champs, examinez les décisions et mettez le modèle sauvegardé au travail.
Dans nos tests, les modèles automatiques ont atteint un F1 de 99,45 à 100 % sur six jeux de données de liaison synthétiques et simulant des erreurs, sans NAS. Sur une population de 10 millions de dossiers Patient, la réponse médiane $match en ligne a pris 25 ms.
Construire à partir de vos données Patient
Choisissez les champs Patient à comparer, comme name, birthDate et address. Prévisualisez leurs valeurs et vérifiez les données manquantes. Une ViewDefinition SQL on FHIR capture votre sélection de champs afin que l'entraînement et le jumelage utilisent les mêmes informations.
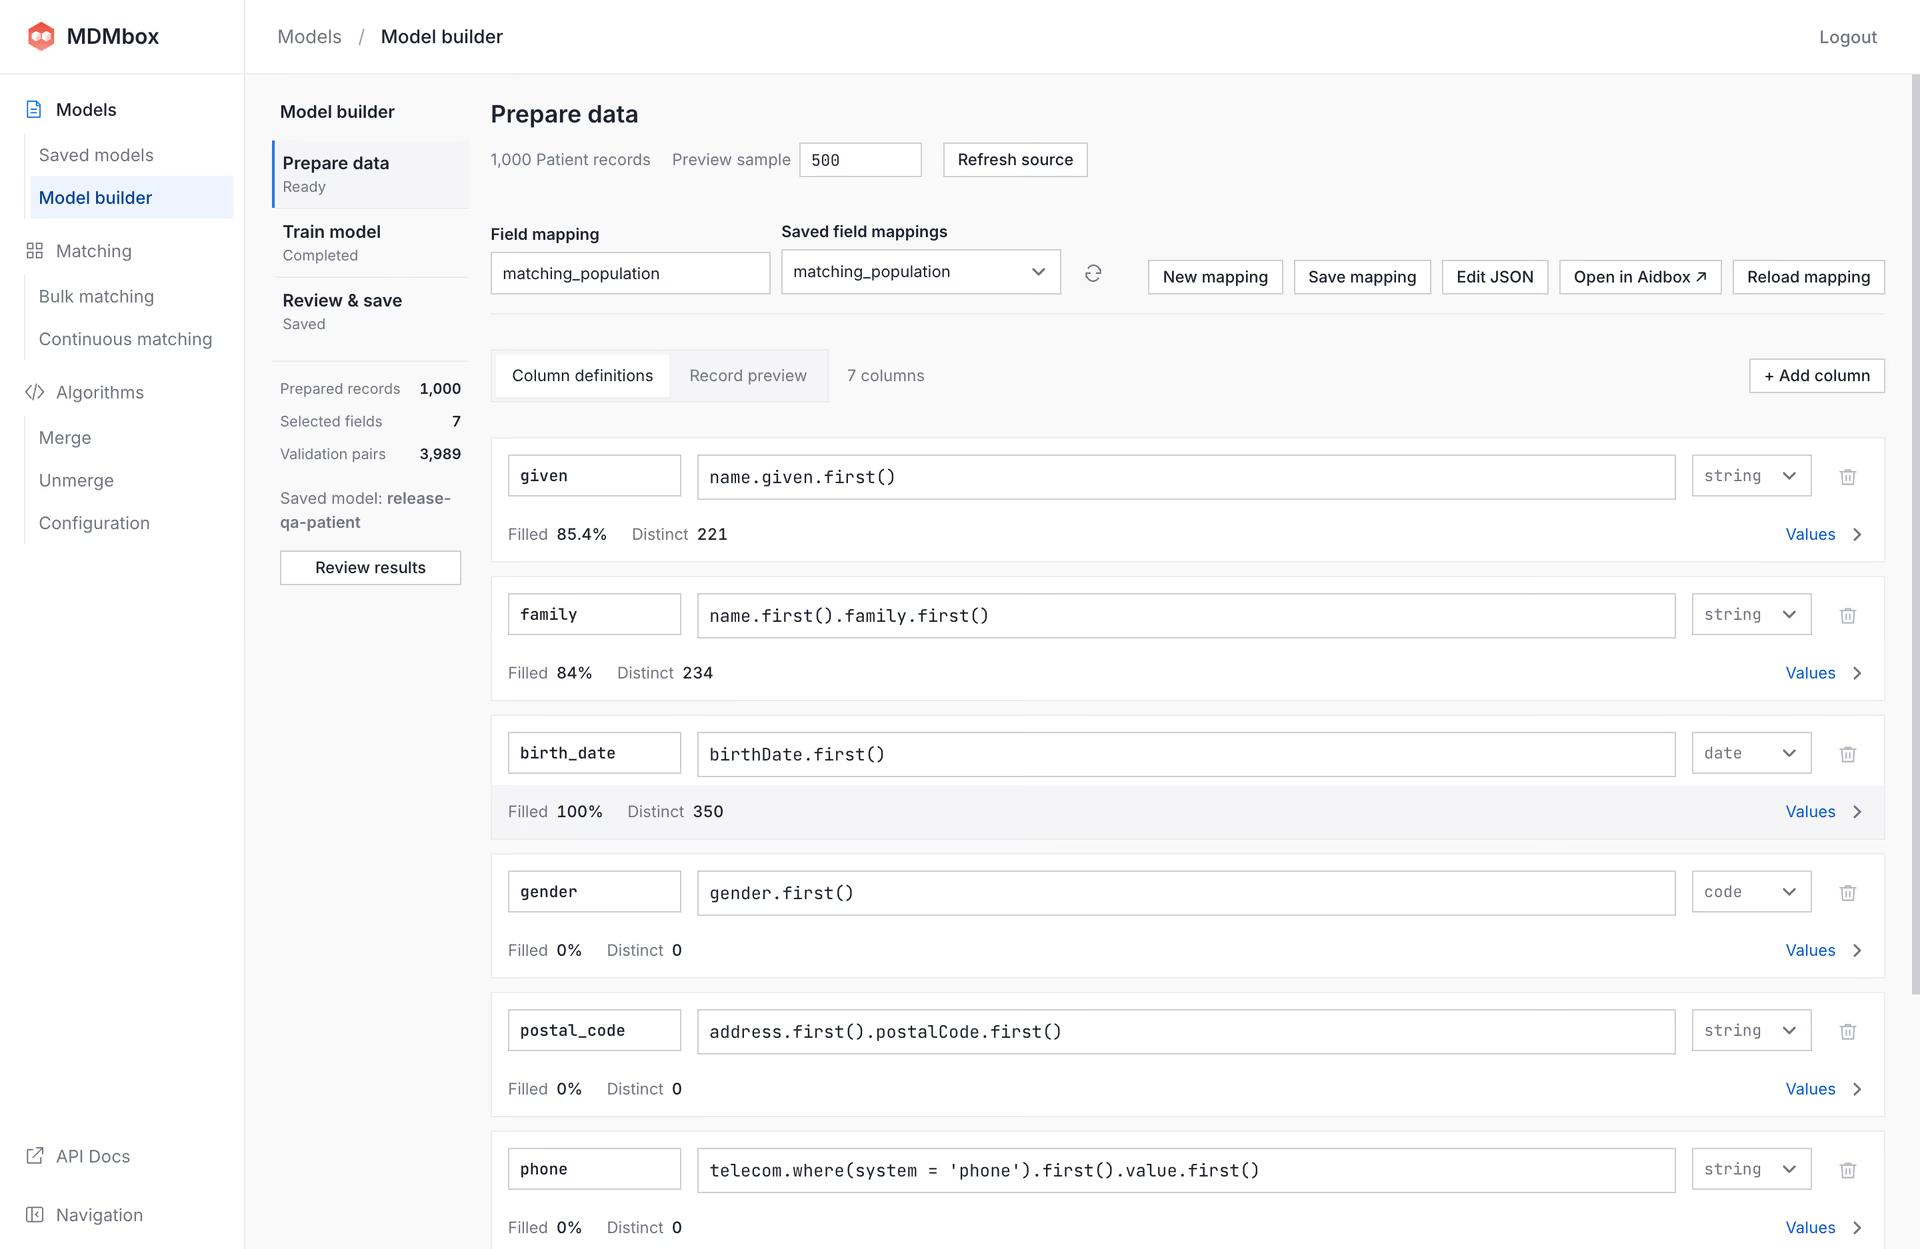
Sélectionnez Construire le modèle. Le générateur choisit les dossiers à comparer et apprend à pondérer leurs similitudes et différences. Il gère les variations orthographiques et les valeurs manquantes, et peut tenir compte des relations entre les champs, comme un code postal permettant de prédire une ville.
Pour une logique personnalisée, vous pouvez modifier les comparaisons en JavaScript, avec un assistant IA optionnel pour vous aider à les rédiger.
Comprendre pourquoi des dossiers correspondent
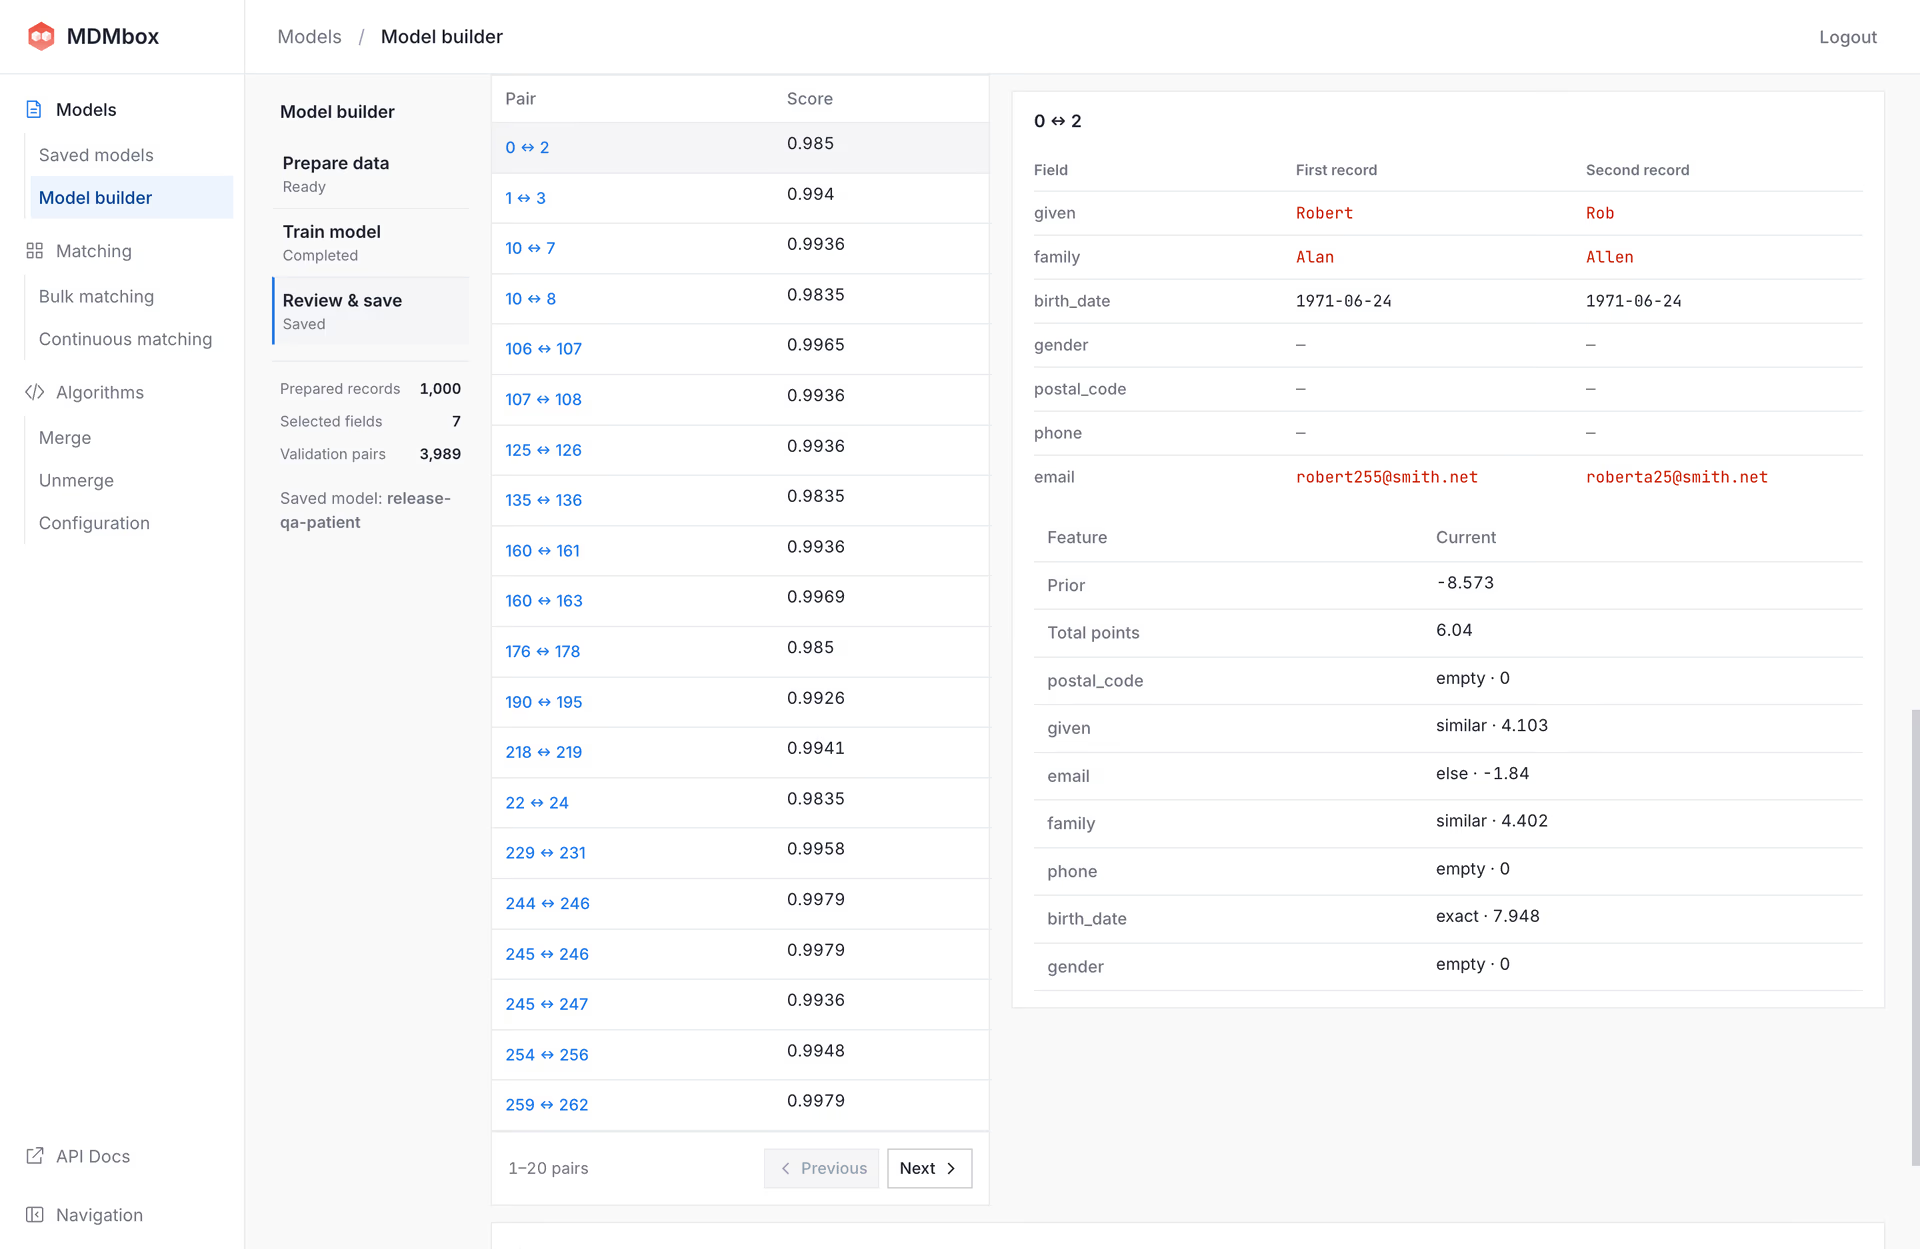
Dans Révision et sauvegarde, vérifiez la distribution des scores et ouvrez les paires individuelles. Chaque explication montre comment les champs sélectionnés ont contribué au score, ce qui vous aide à examiner aussi bien les correspondances probables que les cas incertains.
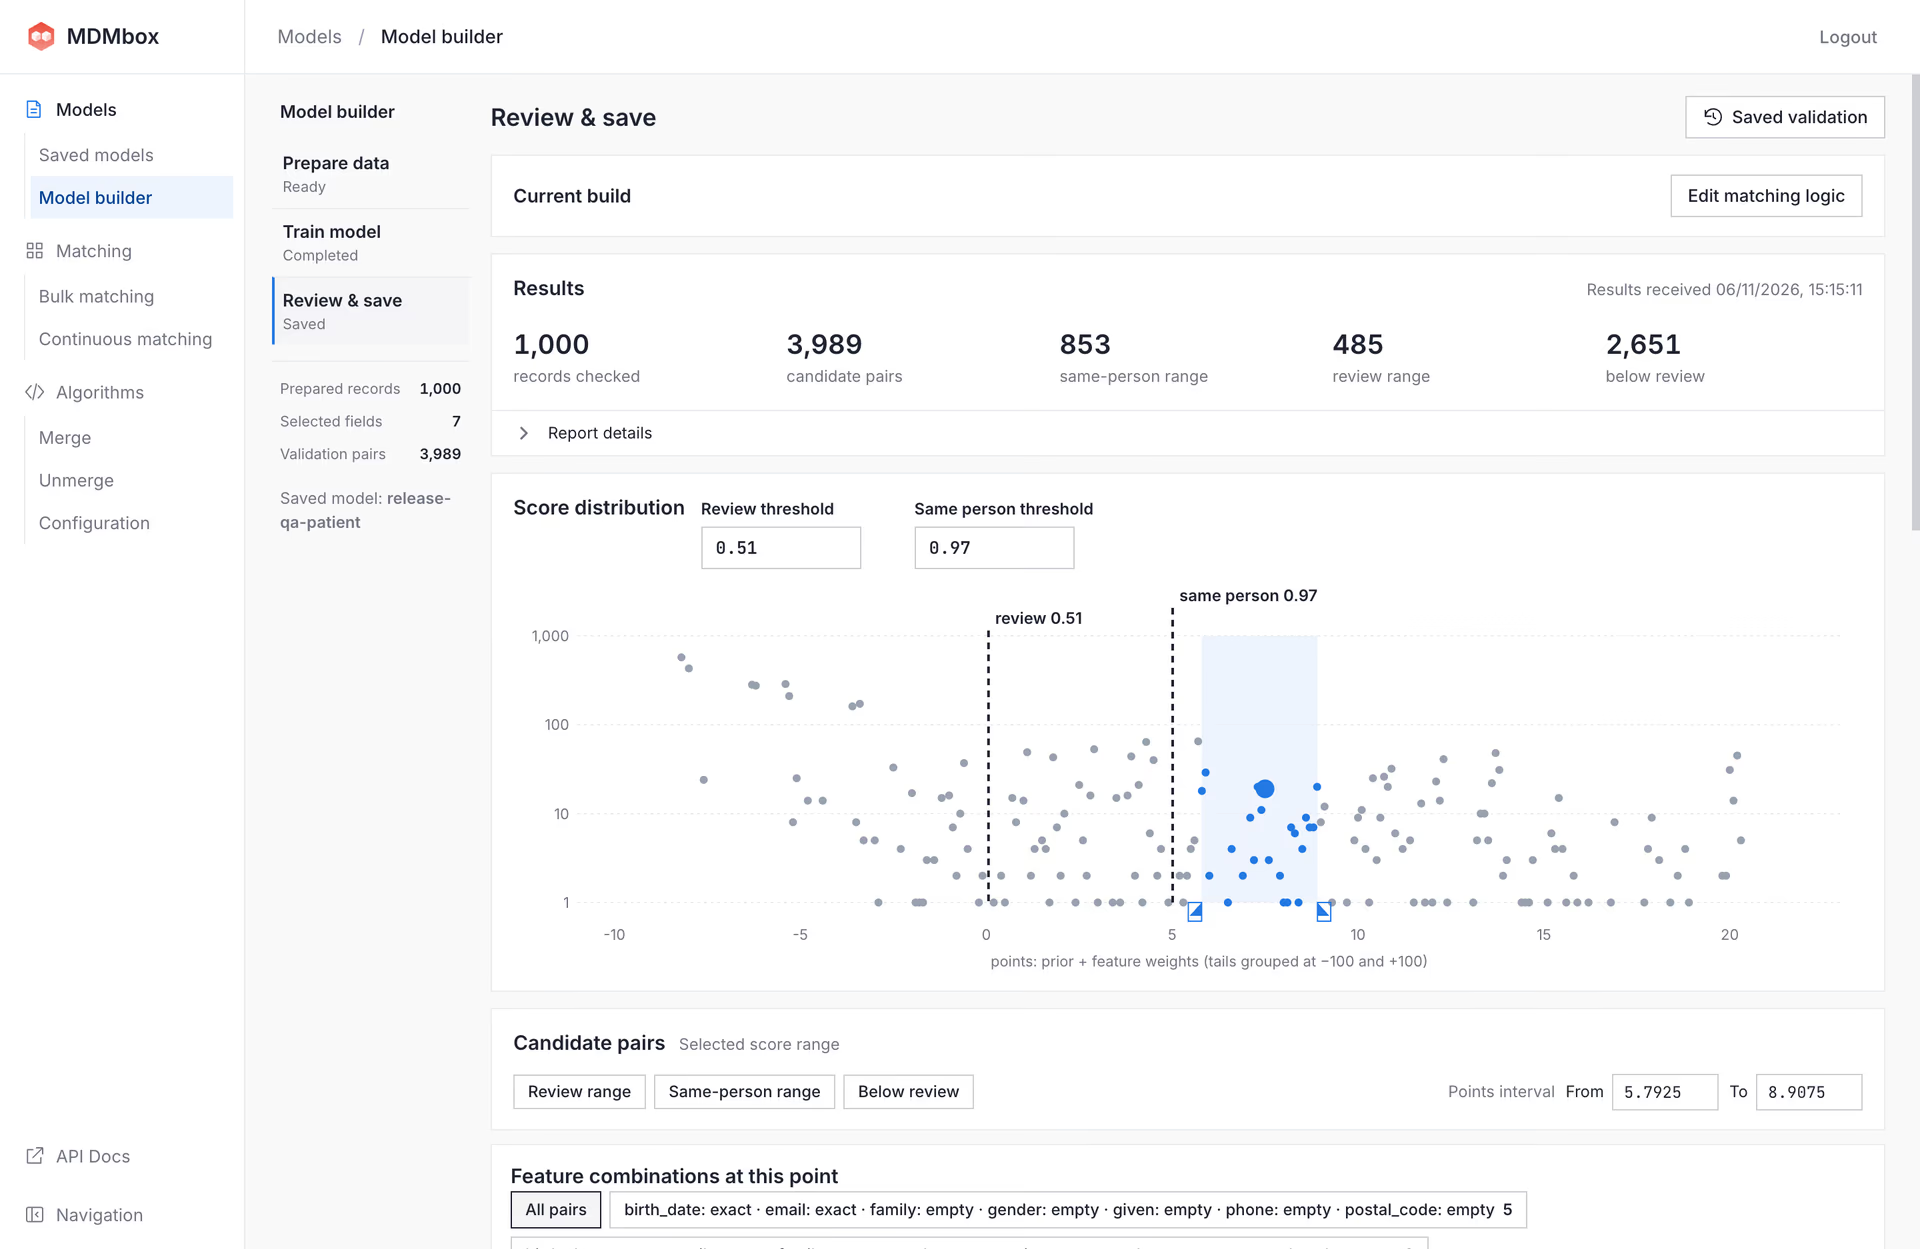
Ajustez le score minimal pour accepter une correspondance ou envoyer une paire en révision. Sauvegardez ensuite un modèle versionné et utilisez-le pour le jumelage en ligne $match, le jumelage en bloc et le jumelage continu. La sélection de champs, les paramètres appris et les seuils restent ensemble dans le même modèle.
Les captures d'écran présentent des données Patient synthétiques.
Qualité du jumelage sans paires d'entraînement étiquetées
Nous avons converti des dossiers provenant de FEBRL, de ePBRN et de NC Voters en ressources FHIR Patient avant l'entraînement. Les identités connues des jeux de données nous ont permis de mesurer la précision, le rappel et le F1 par la suite. Ces étiquettes n'ont pas été utilisées lors de l'entraînement, et les correspondances manquées lors de la sélection des candidats sont comptabilisées dans le rappel.
Sur les six jeux de données synthétiques et simulant des erreurs de plus petite taille, l'entraînement automatique a produit les résultats suivants sans identifiants de numéro d'assurance sociale ni règles de comparaison écrites manuellement :
| Jeu de données | Précision | Rappel | F1 |
|---|---|---|---|
| FEBRL1 | 100 % | 100 % | 100 % |
| FEBRL2 | 100 % | 99,49 % | 99,75 % |
| FEBRL3 | 100 % | 98,91 % | 99,45 % |
| FEBRL4 | 100 % | 99,53 % | 99,77 % |
| ePBRN D | 100 % | 99,61 % | 99,81 % |
| ePBRN F | 100 % | 99,28 % | 99,64 % |
Chaque paire acceptée était correcte dans ces tests. Les jeux de test contiennent de 158 à 1 924 paires connues de même personne chacun.
Jumelage sur 5 M et 10 M de dossiers
Les jeux de données NC plus volumineux utilisent des noms et des informations d'adresse dérivés de listes électorales, avec des doublons générés. Nous avons testé le jumelage pour 5 000 dossiers par population. L'ajustement des seuils d'acceptation sur des exemples étiquetés distincts a permis de retrouver davantage de vraies correspondances et d'élever le F1 au-dessus de 91,6 %, sans ré-entraînement :
| Population | Paramètre | Précision | Rappel | F1 |
|---|---|---|---|---|
| NC Voters 5M | Automatique | 95,58 % | 73,91 % | 83,36 % |
| NC Voters 5M | Seuil ajusté | 91,56 % | 92,03 % | 91,79 % |
| NC Voters 10M | Automatique | 95,37 % | 76,45 % | 84,87 % |
| NC Voters 10M | Seuil ajusté | 92,23 % | 91,13 % | 91,68 % |
L'ajustement du seuil a troqué une partie de la précision contre un rappel sensiblement plus élevé. Les téléchargements comprennent les résultats de qualité complets, y compris les résultats pour les dossiers dont les valeurs ont été modifiées.
Jumelage à la milliseconde sur 10 millions de dossiers
Sur un Apple M1 Pro avec 16 Go de RAM, l'entraînement automatique a pris environ 22 minutes pour 5 M de dossiers Patient et 30 minutes pour 10 M, après la préparation des données.
Dans les tests en ligne, les réponses médianes $match ont pris 28 ms à 5 M et 25 ms à 10 M. 95 % des réponses sont arrivées en moins de 56 ms sur les deux populations. Les chiffres d'entraînement excluent l'importation des données et la configuration initiale en ligne.
Essayer le Générateur de modèles
Ouvrez Modèles → Générateur de modèles dans MDMbox 2610.0 pour entraîner votre premier modèle. Consultez la documentation ou réservez une démonstration pour discuter de votre flux de travail de jumelage Patient avec notre équipe.
Essayez les mêmes données d'entrée en utilisant les huit jeux de données téléchargeables. Chacun comprend des données FHIR Patient en NDJSON, sa ViewDefinition et un fichier CSV complet d'étiquettes d'identité distinct, incluant les singletons. Les étiquettes sont destinées à l'évaluation externe ; elles ne constituent pas des données d'entraînement ni un format de téléversement d'étiquettes MDMbox. La documentation de téléchargement comprend l'attribution des sources, les conditions d'utilisation et les sommes de contrôle.
Pour un premier essai à petite échelle, téléchargez FEBRL1 : données Patient, correspondance de champs et étiquettes d'évaluation.
Téléchargez les modèles mesurés et les résultats de qualité complets pour FEBRL, ePBRN et NC Voters. Les archives contiennent les définitions de modèles et les résultats, sans les données Patient sources.