Ein falsch geschriebener Name oder eine veraltete Adresse kann einen doppelten Patientendatensatz verbergen. Der Model Builder in MDMbox 2610.0 erlernt Matching-Parameter aus Ihren FHIR-Patient-Daten – ohne beschriftete Trainingspaare. Sie wählen die Felder, prüfen die Entscheidungen und setzen das gespeicherte Modell ein.
In unseren Tests erreichten automatische Modelle 99,45–100 % F1 über sechs synthetische und fehler-simulierte Linkage-Datensätze ohne SSN. Bei einer Population von 10 Millionen Patientendatensätzen betrug die mediane Online-$match-Antwortzeit 25 ms.
Modell aus Ihren Patientendaten erstellen
Wählen Sie die zu vergleichenden Patient-Felder, etwa name, birthDate und address. Sehen Sie sich die Werte in der Vorschau an und prüfen Sie auf fehlende Daten. Eine SQL on FHIR ViewDefinition speichert Ihre Feldauswahl, sodass Training und Matching dieselben Informationen verwenden.
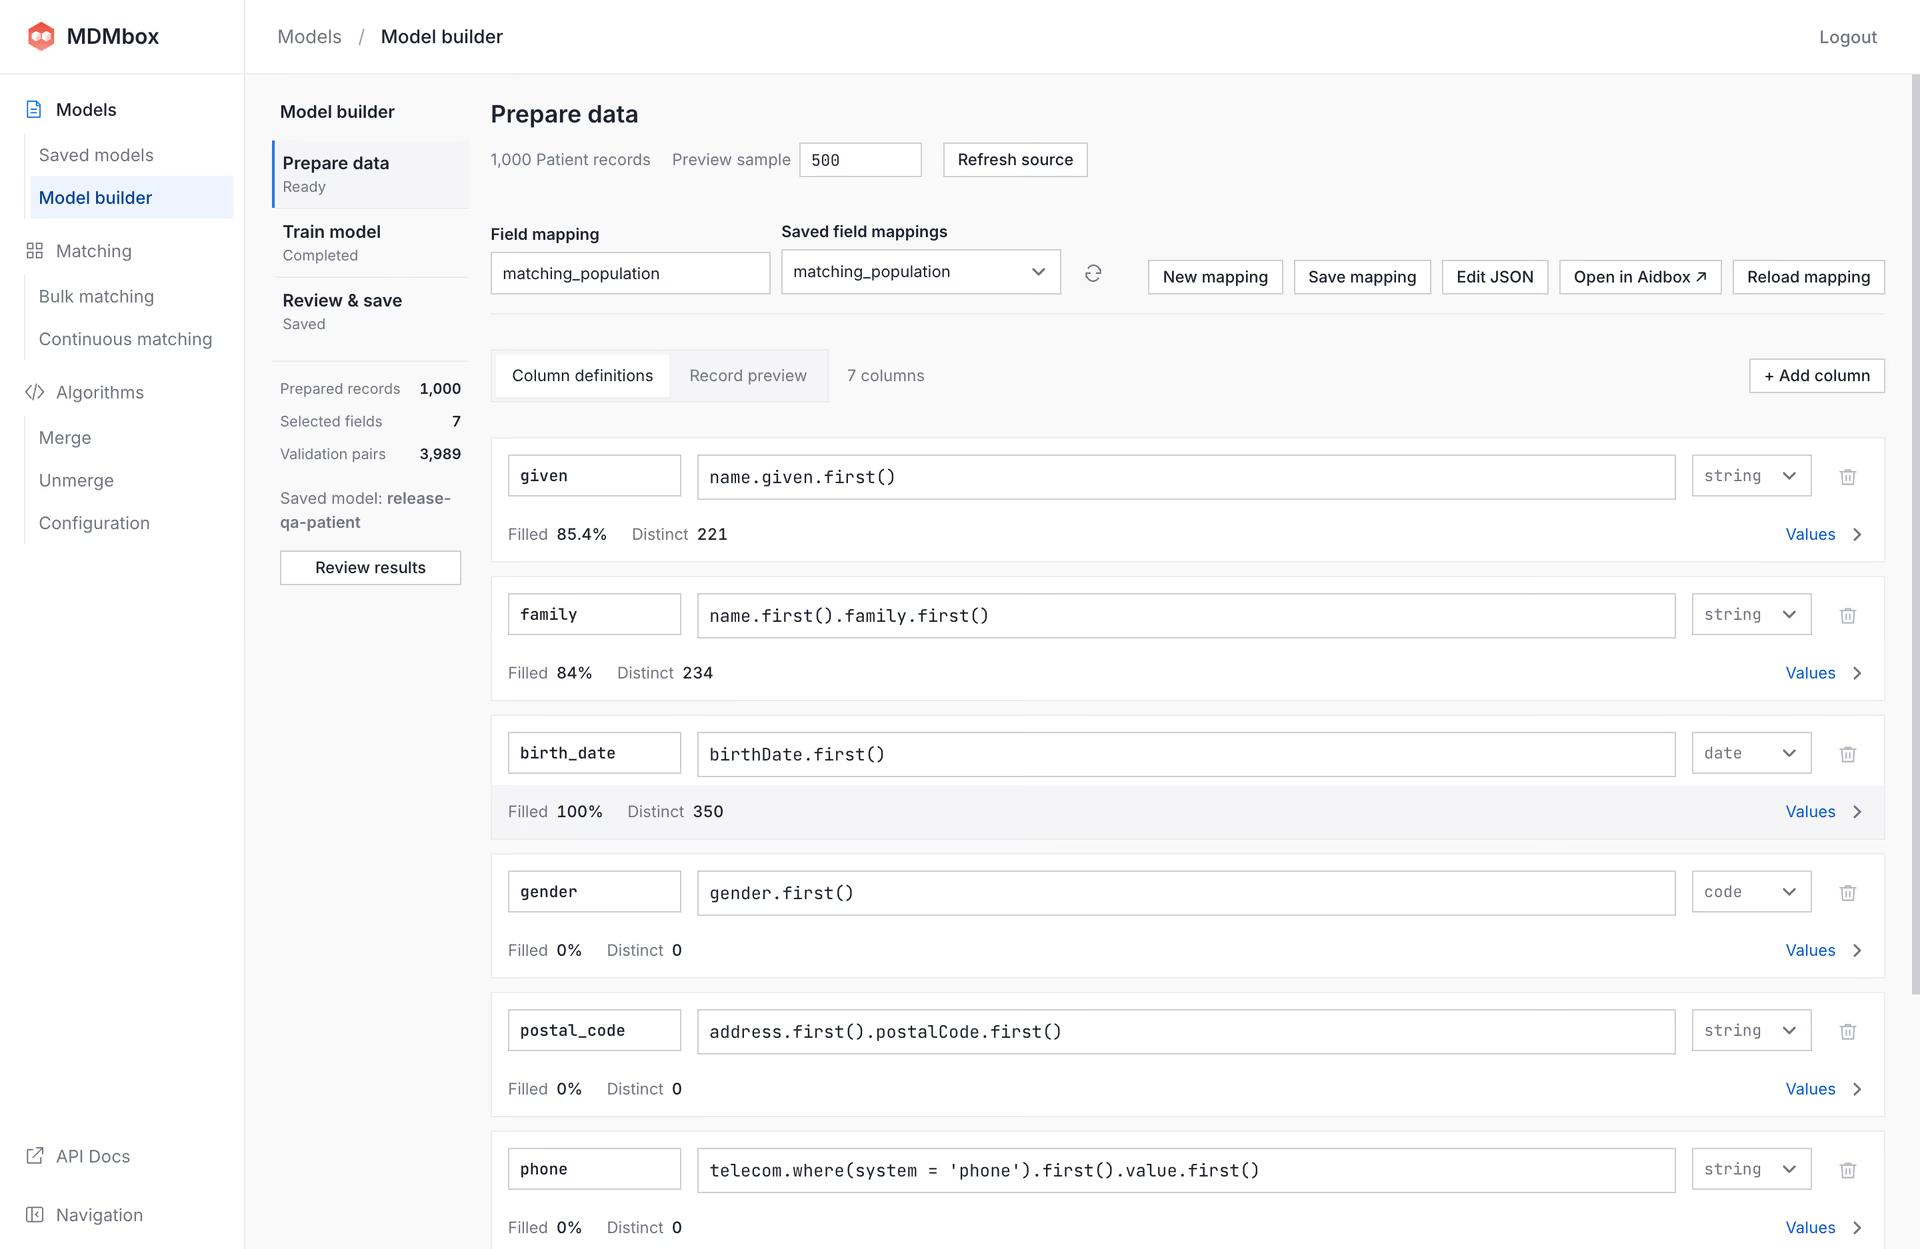
Wählen Sie Modell erstellen. Der Builder entscheidet, welche Datensätze verglichen werden, und erlernt, wie Ähnlichkeiten und Unterschiede gewichtet werden sollen. Er berücksichtigt Schreibvarianten und fehlende Werte und kann Beziehungen zwischen Feldern einbeziehen, etwa die Vorhersage einer Stadt anhand der Postleitzahl.
Für benutzerdefinierte Logik können Sie Vergleiche in JavaScript bearbeiten, unterstützt von einem optionalen KI-Assistenten.
Nachvollziehen, warum Datensätze übereinstimmen
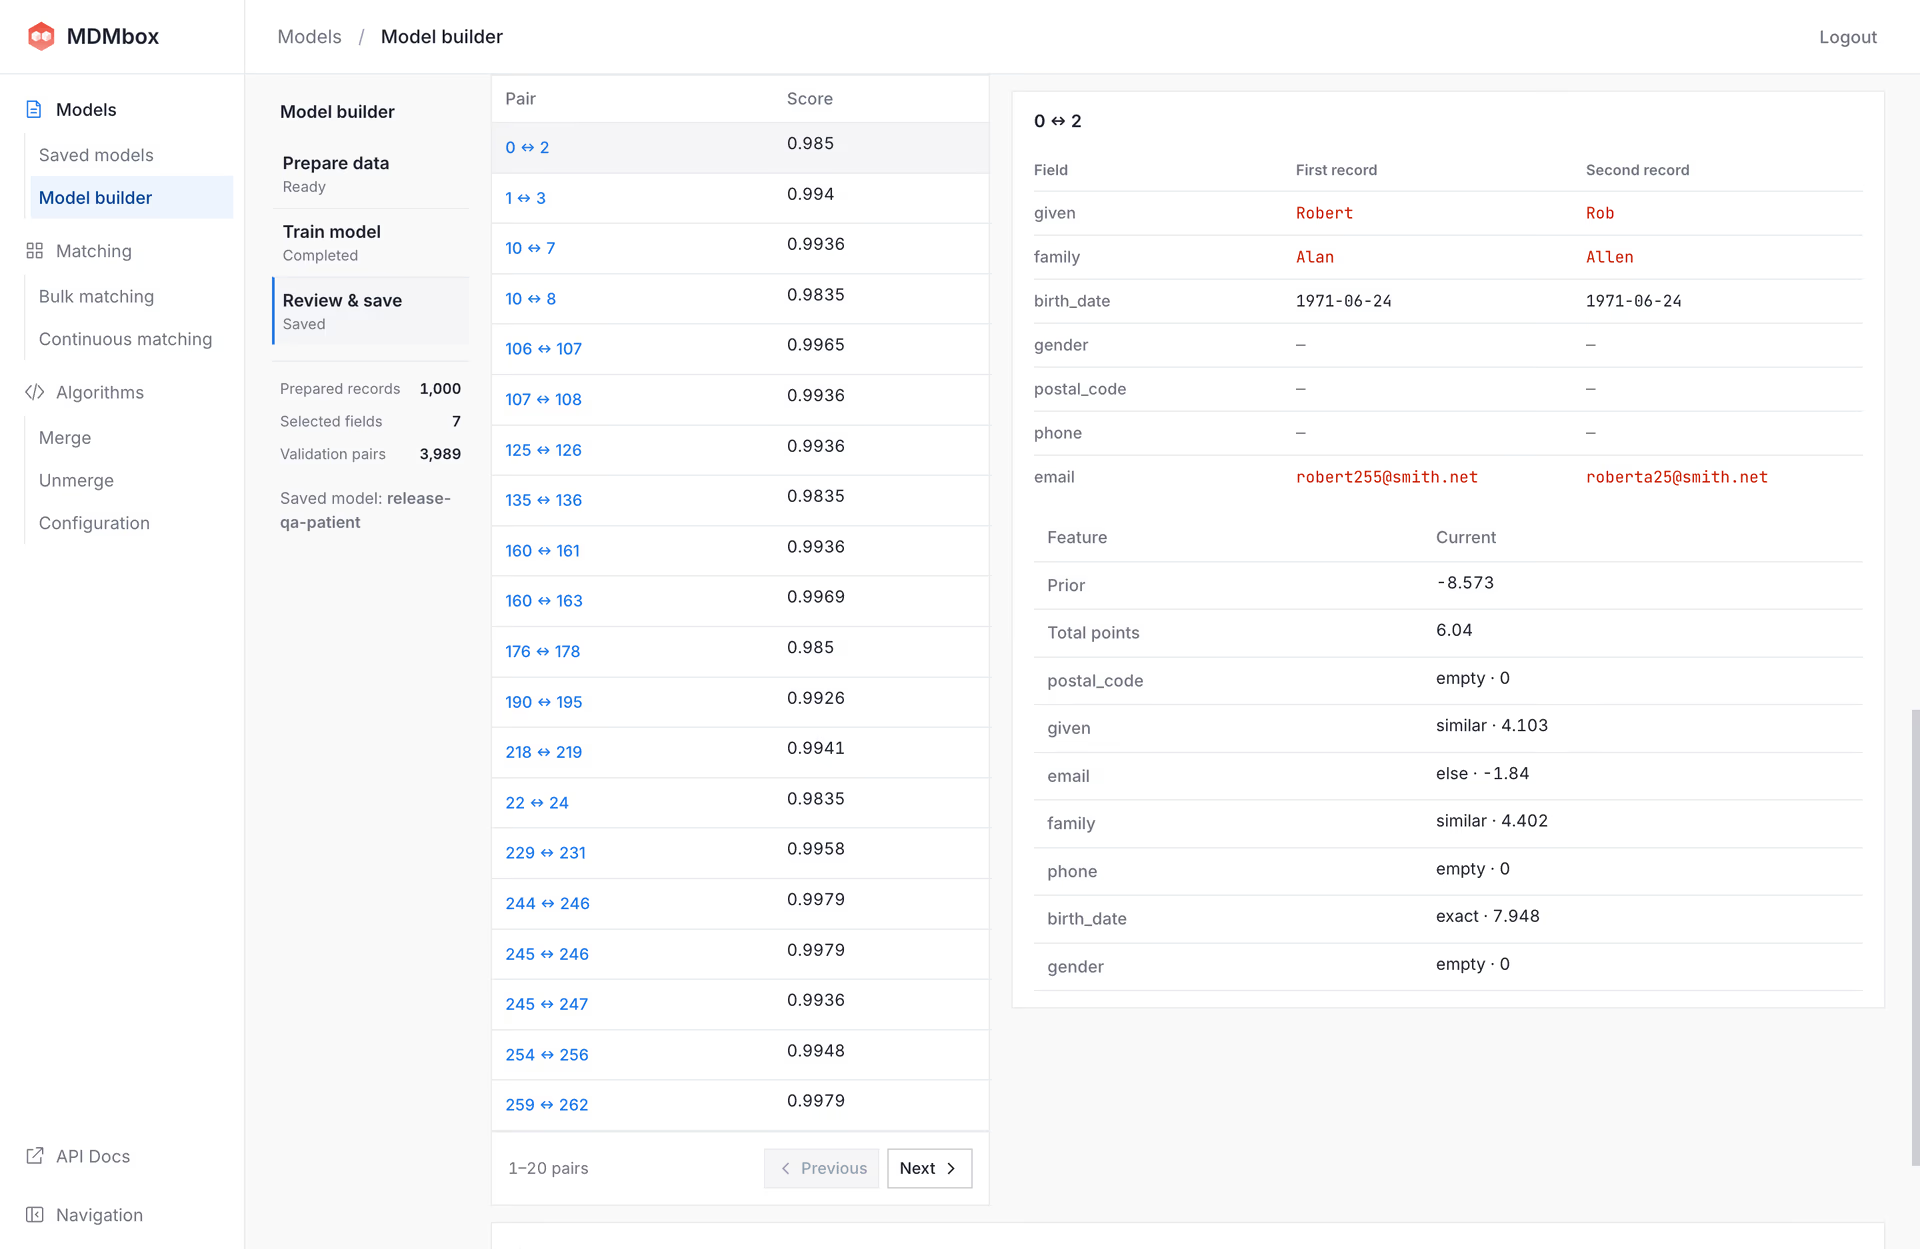
Prüfen Sie unter Überprüfen & Speichern die Score-Verteilung und öffnen Sie einzelne Paare. Jede Erklärung zeigt, wie die ausgewählten Felder zum Score beigetragen haben – so können Sie sowohl wahrscheinliche Treffer als auch unsichere Fälle untersuchen.
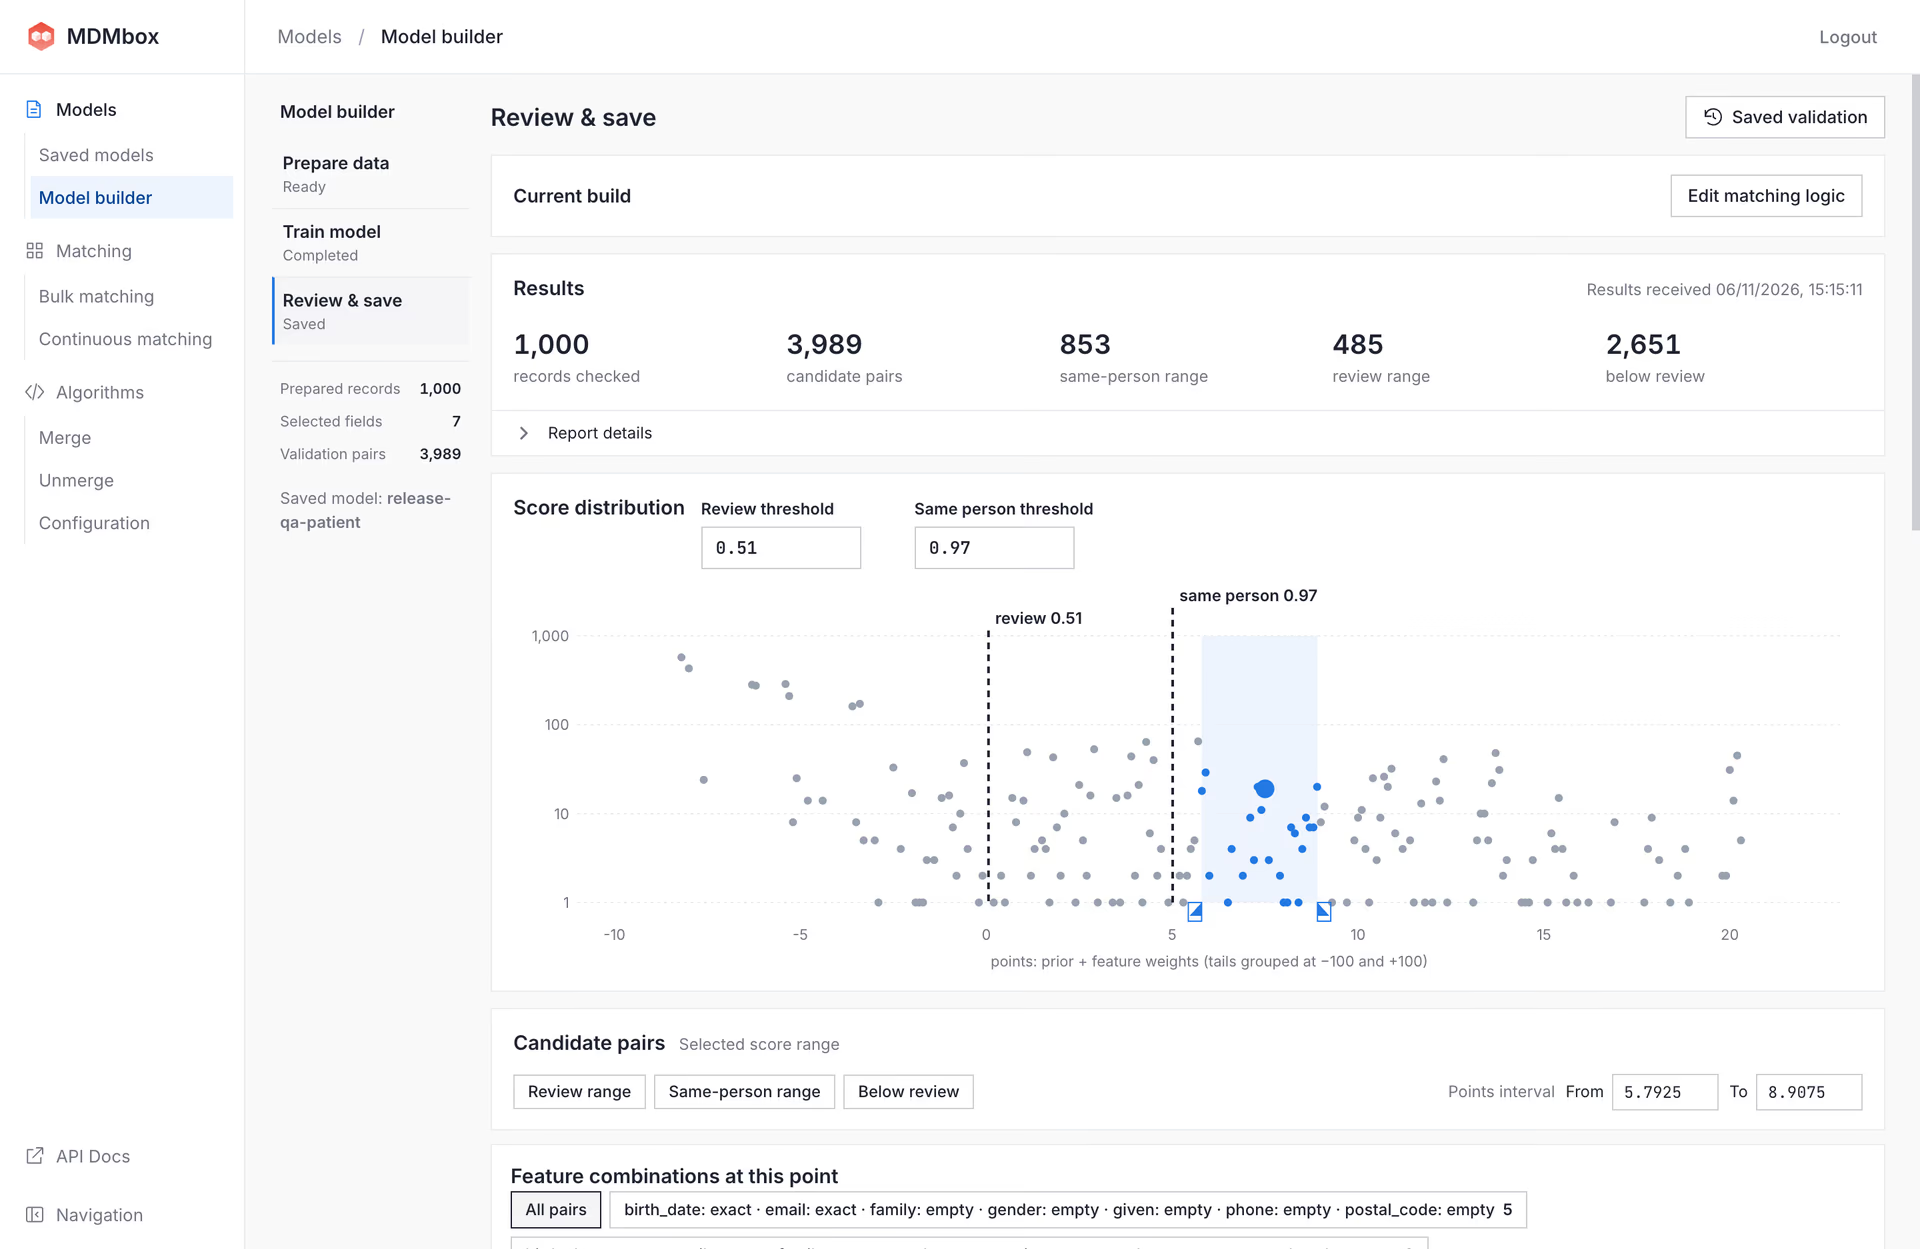
Passen Sie den Mindestscore für die Akzeptanz eines Treffers oder die Weiterleitung eines Paares zur Überprüfung an. Speichern Sie anschließend ein versioniertes Modell und verwenden Sie es für Online-$match, Bulk Matching und Continuous Matching. Die Feldauswahl, die erlernten Parameter und die Schwellenwerte sind im selben Modell zusammengefasst.
Die Screenshots zeigen synthetische Patientendaten.
Matching-Qualität ohne beschriftete Trainingspaare
Wir haben Datensätze aus FEBRL, ePBRN und NC Voters vor dem Training in FHIR-Patient-Ressourcen konvertiert. Die bekannten Identitäten der Datensätze ermöglichten es uns, Präzision, Recall und F1 im Nachhinein zu messen. Diese Beschriftungen wurden vom Training ausgeschlossen, und während der Kandidatenauswahl verpasste Treffer werden beim Recall negativ berücksichtigt.
Bei den sechs kleineren synthetischen und fehler-simulierten Datensätzen lieferte das automatische Training folgende Ergebnisse ohne Sozialversicherungskennungen oder handgeschriebene Vergleichsregeln:
| Datensatz | Präzision | Recall | F1 |
|---|---|---|---|
| FEBRL1 | 100 % | 100 % | 100 % |
| FEBRL2 | 100 % | 99,49 % | 99,75 % |
| FEBRL3 | 100 % | 98,91 % | 99,45 % |
| FEBRL4 | 100 % | 99,53 % | 99,77 % |
| ePBRN D | 100 % | 99,61 % | 99,81 % |
| ePBRN F | 100 % | 99,28 % | 99,64 % |
Jedes akzeptierte Paar war in diesen Tests korrekt. Die Testmengen enthalten jeweils 158–1.924 bekannte Paare derselben Person.
Matching bei 5 Mio. und 10 Mio. Datensätzen
Die größeren NC-Benchmarks verwenden wählerbasierte Namen und Adressinformationen mit generierten Duplikaten. Wir haben das Matching für 5.000 Datensätze pro Population getestet. Durch Anpassung der Akzeptanzschwellen an separaten beschrifteten Beispielen konnten mehr echte Treffer gefunden und F1 auf über 91,6 % gehoben werden – ohne erneutes Training:
| Population | Einstellung | Präzision | Recall | F1 |
|---|---|---|---|---|
| NC Voters 5M | Automatisch | 95,58 % | 73,91 % | 83,36 % |
| NC Voters 5M | Schwelle angepasst | 91,56 % | 92,03 % | 91,79 % |
| NC Voters 10M | Automatisch | 95,37 % | 76,45 % | 84,87 % |
| NC Voters 10M | Schwelle angepasst | 92,23 % | 91,13 % | 91,68 % |
Die Anpassung des Schwellenwerts tauschte etwas Präzision gegen einen deutlich höheren Recall ein. Die Downloads enthalten die vollständigen Qualitätsergebnisse, einschließlich der Ergebnisse für Datensätze mit geänderten Werten.
Matching in Millisekunden bei 10 Millionen Datensätzen
Auf einem Apple M1 Pro mit 16 GB RAM dauerte das automatische Training nach der Datenvorbereitung etwa 22 Minuten für 5 Mio. Patientendatensätze und 30 Minuten für 10 Mio.
Bei Online-Tests betrugen die medianen $match-Antwortzeiten 28 ms bei 5 Mio. und 25 ms bei 10 Mio. Datensätzen. 95 % der Anfragen wurden innerhalb von 56 ms in beiden Populationen beantwortet. Die Trainingszeiten schließen den Datenimport und die erstmalige Online-Einrichtung nicht ein.
Model Builder ausprobieren
Öffnen Sie Models → Model builder in MDMbox 2610.0, um Ihr erstes Modell zu trainieren. Folgen Sie der Dokumentation oder vereinbaren Sie eine Demo, um Ihren Patient-Matching-Workflow mit unserem Team zu besprechen.
Probieren Sie dieselben Eingaben mit den acht herunterladbaren Datensätzen aus. Jeder enthält FHIR-Patient-NDJSON, die zugehörige ViewDefinition und eine separate vollständige Identitätslabel-CSV, einschließlich Singletons. Die Beschriftungen dienen der externen Auswertung; sie sind keine Trainingseingaben und kein MDMbox-Label-Upload-Format. Die Download-Dokumentation enthält Quellenangaben, Nutzungsbedingungen und Prüfsummen.
Für einen ersten kleinen Test laden Sie FEBRL1 herunter: Patientendaten, Feldzuordnung und Auswertungslabels.
Laden Sie die gemessenen Modelle und vollständigen Qualitätsergebnisse für FEBRL, ePBRN und NC Voters herunter. Die Archive enthalten Modelldefinitionen und Ergebnisse, jedoch keine Quell-Patientendaten.