Un nombre mal escrito o una dirección desactualizada pueden ocultar un registro de paciente duplicado. El constructor de modelos en MDMbox 2610.0 aprende los parámetros de emparejamiento a partir de sus datos FHIR de pacientes, sin necesidad de pares de entrenamiento etiquetados. Usted elige los campos, inspecciona las decisiones y pone a trabajar el modelo guardado.
En nuestras pruebas, los modelos automáticos alcanzaron un F1 del 99,45–100 % en seis conjuntos de datos de vinculación sintéticos y con errores simulados, sin SSN. Frente a una población de 10 millones de registros de pacientes, la respuesta mediana de $match en línea fue de 25 ms.
Construya a partir de sus datos de pacientes
Elija los campos de paciente que desea comparar, como name, birthDate y address. Previsualice sus valores y compruebe si faltan datos. Una ViewDefinition de SQL on FHIR captura su selección de campos para que el entrenamiento y el emparejamiento utilicen la misma información.
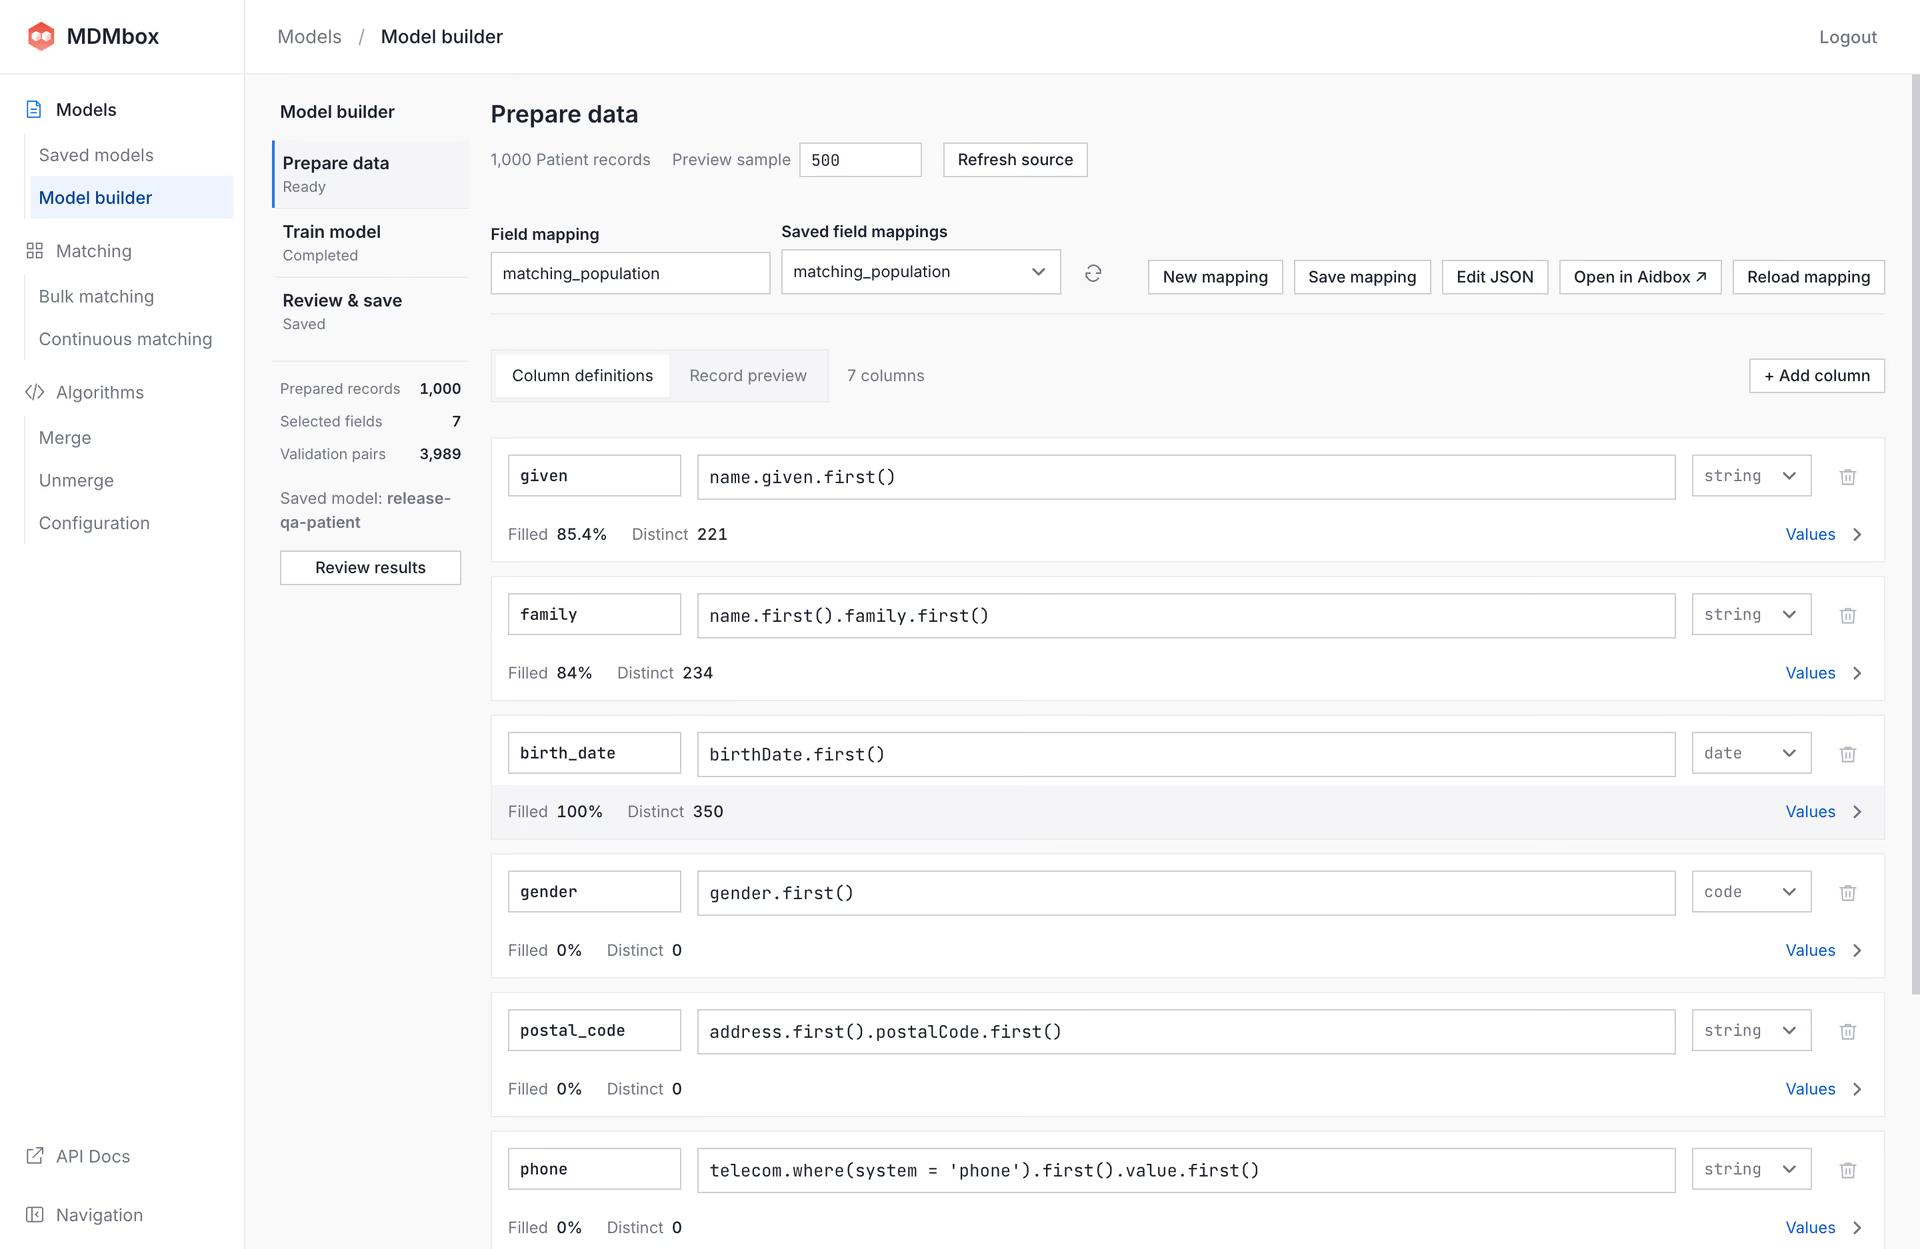
Seleccione Build model. El constructor elige qué registros comparar y aprende a ponderar sus similitudes y diferencias. Gestiona variaciones ortográficas y valores ausentes, y puede tener en cuenta las relaciones entre campos, como un código postal que predice una ciudad.
Para lógica personalizada, puede editar comparaciones en JavaScript, con un asistente de IA opcional para ayudar a redactarlas.
Vea por qué los registros coinciden
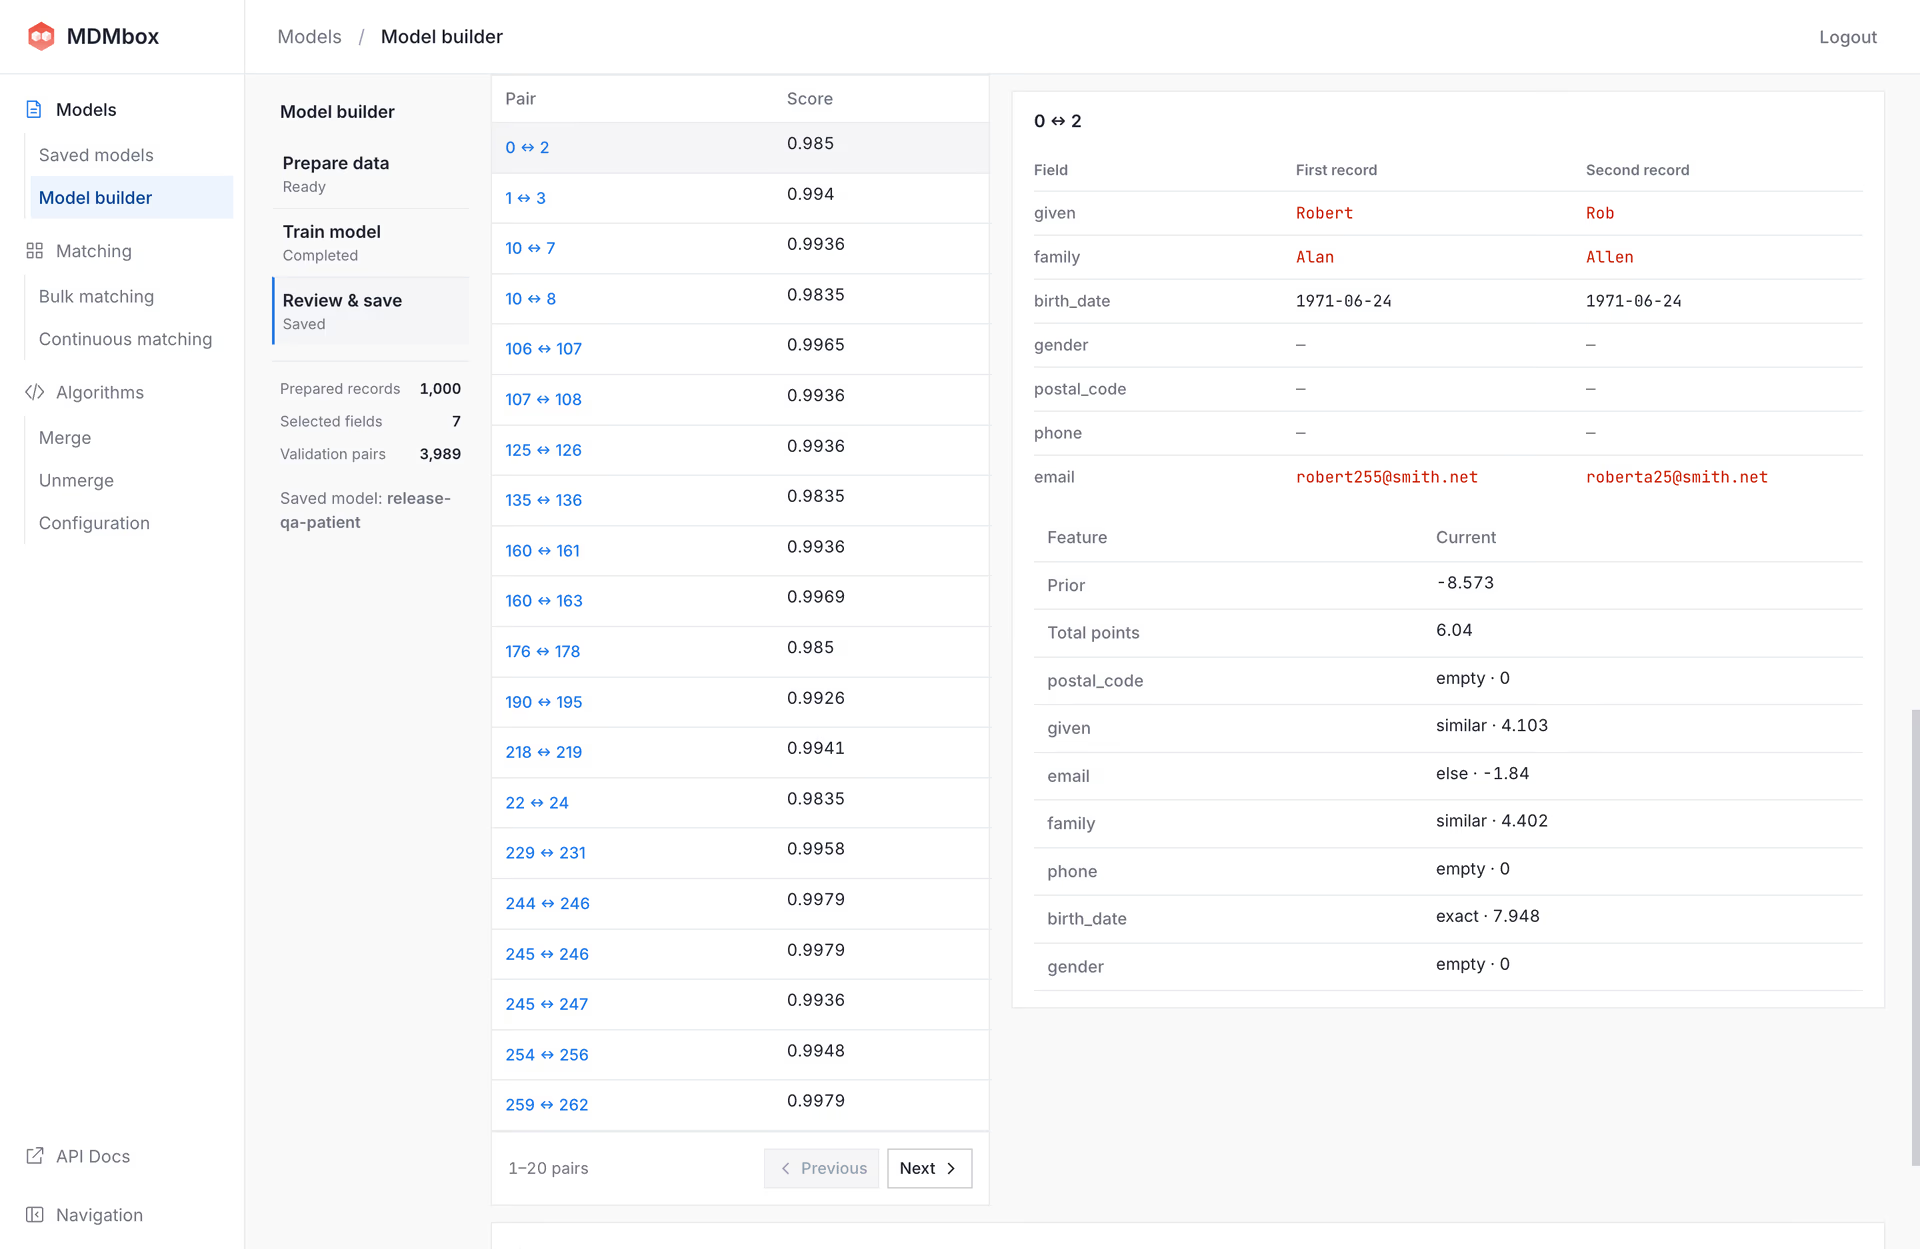
En Review & save, compruebe la distribución de puntuaciones y abra pares individuales. Cada explicación muestra cómo los campos seleccionados han contribuido a la puntuación, lo que le ayuda a investigar tanto las coincidencias probables como los casos inciertos.
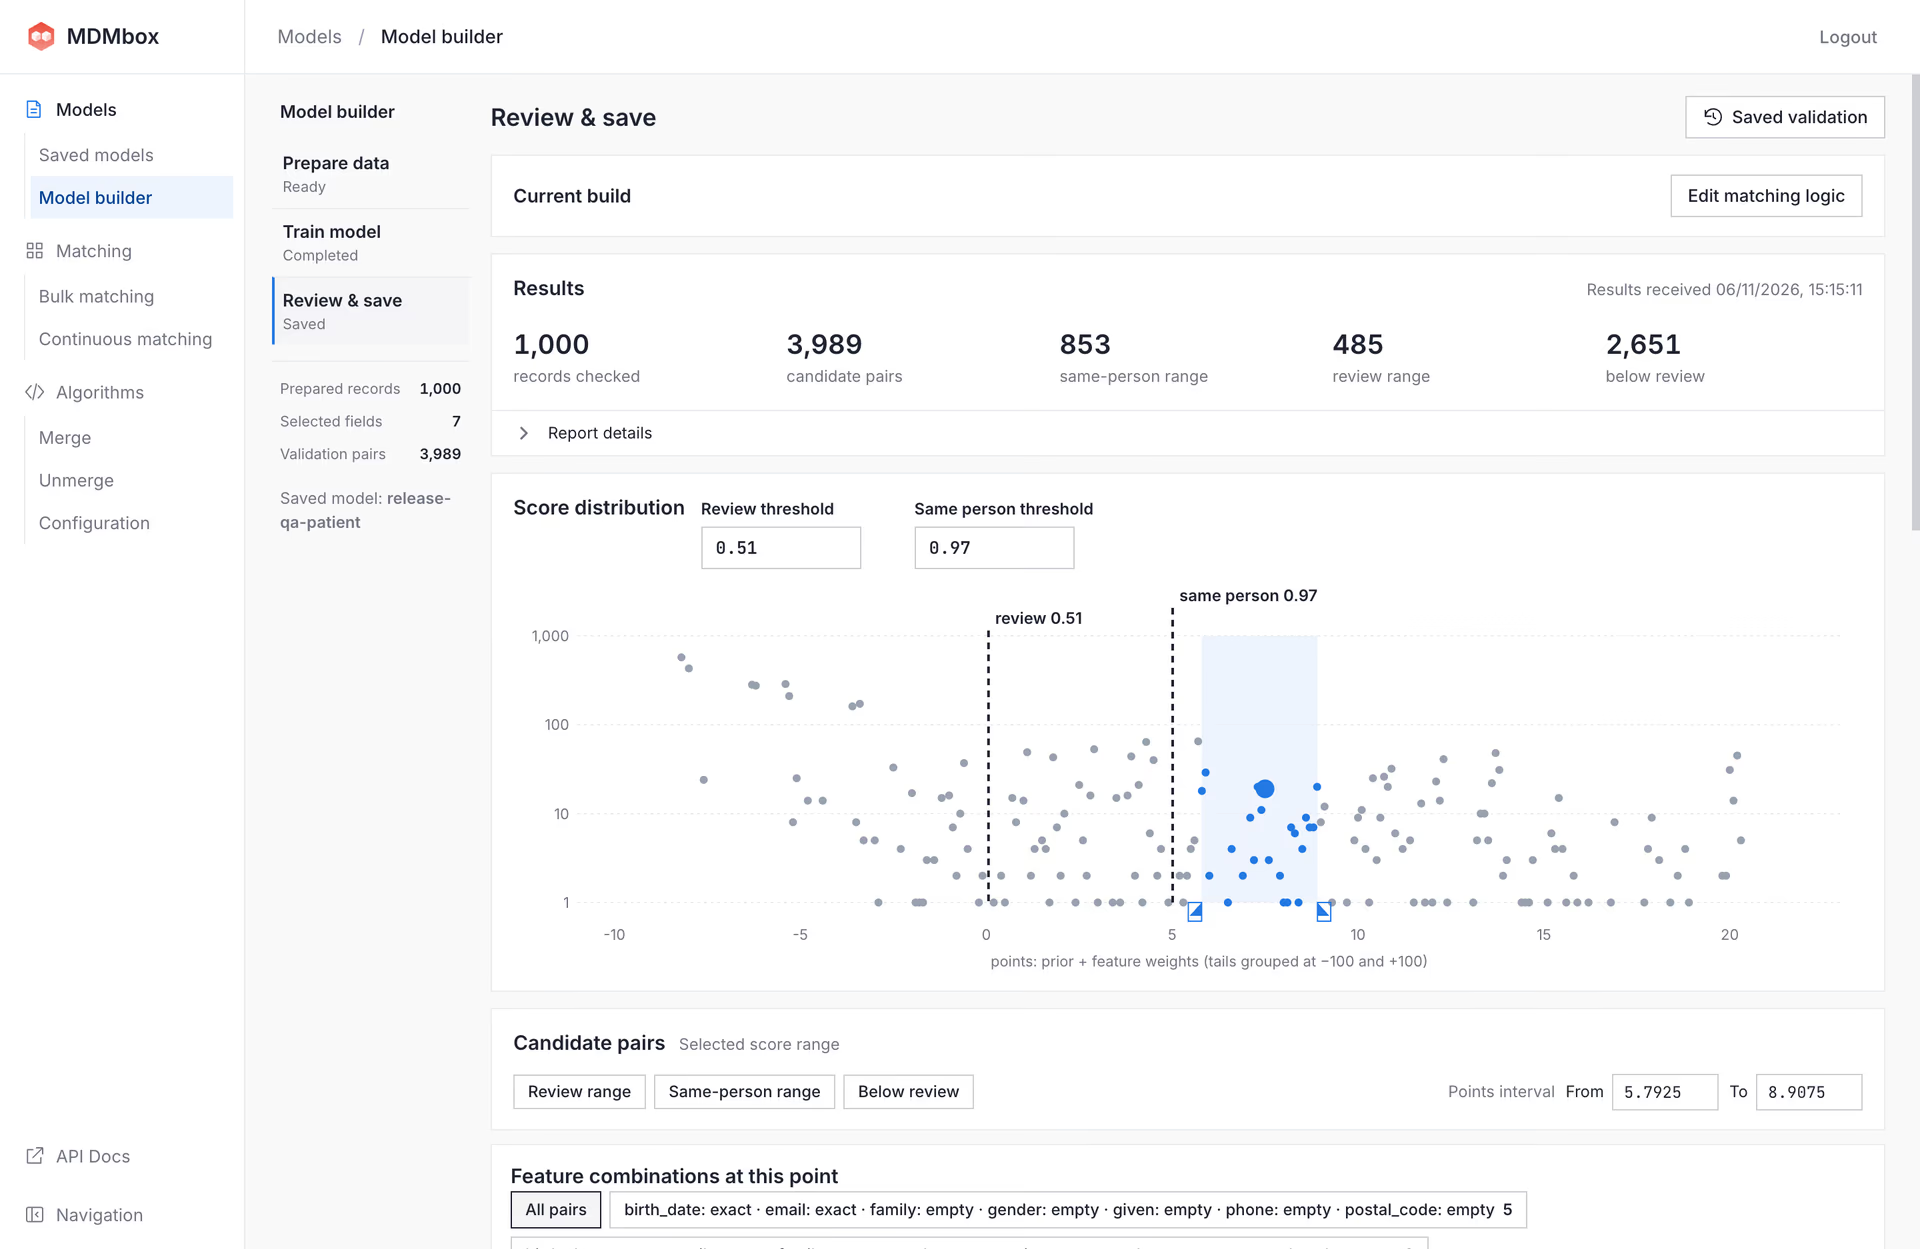
Ajuste la puntuación mínima para aceptar una coincidencia o enviar un par a revisión. A continuación, guarde un modelo versionado y utilícelo para el emparejamiento en línea con $match, el Bulk matching y el Continuous matching. La selección de campos, los parámetros aprendidos y los umbrales permanecen juntos en el mismo modelo.
Las capturas de pantalla muestran datos sintéticos de pacientes.
Calidad de emparejamiento sin pares de entrenamiento etiquetados
Convertimos registros de FEBRL, ePBRN y NC Voters en recursos FHIR Patient antes del entrenamiento. Las identidades conocidas de los conjuntos de datos nos permitieron medir la precisión, la exhaustividad y el F1 a posteriori. Dichas etiquetas se mantuvieron fuera del entrenamiento, y las coincidencias no detectadas durante la selección de candidatos penalizan la exhaustividad.
En los seis conjuntos de datos sintéticos más pequeños y con errores simulados, el entrenamiento automático produjo estos resultados sin identificadores de seguridad social ni reglas de comparación escritas manualmente:
| Conjunto de datos | Precisión | Exhaustividad | F1 |
|---|---|---|---|
| FEBRL1 | 100 % | 100 % | 100 % |
| FEBRL2 | 100 % | 99,49 % | 99,75 % |
| FEBRL3 | 100 % | 98,91 % | 99,45 % |
| FEBRL4 | 100 % | 99,53 % | 99,77 % |
| ePBRN D | 100 % | 99,61 % | 99,81 % |
| ePBRN F | 100 % | 99,28 % | 99,64 % |
Todos los pares aceptados fueron correctos en estas pruebas. Los conjuntos de prueba contienen entre 158 y 1924 pares conocidos de la misma persona cada uno.
Emparejamiento con 5 M y 10 M de registros
Los conjuntos de referencia de NC más grandes utilizan nombres e información de dirección derivados de registros de votantes con duplicados generados. Probamos el emparejamiento para 5000 registros por población. Ajustando los umbrales de aceptación en ejemplos etiquetados separados se recuperaron más coincidencias verdaderas y el F1 superó el 91,6 %, sin reentrenamiento:
| Población | Configuración | Precisión | Exhaustividad | F1 |
|---|---|---|---|---|
| NC Voters 5M | Automática | 95,58 % | 73,91 % | 83,36 % |
| NC Voters 5M | Umbral ajustado | 91,56 % | 92,03 % | 91,79 % |
| NC Voters 10M | Automática | 95,37 % | 76,45 % | 84,87 % |
| NC Voters 10M | Umbral ajustado | 92,23 % | 91,13 % | 91,68 % |
El ajuste del umbral intercambió algo de precisión por una exhaustividad considerablemente mayor. Las descargas incluyen los resultados completos de calidad, incluyendo los resultados para registros con valores modificados.
Emparejamiento en milisegundos con 10 millones de registros
En un Apple M1 Pro con 16 GB de RAM, el entrenamiento automático tardó aproximadamente 22 minutos para 5 M de registros de pacientes y 30 minutos para 10 M, tras la preparación de los datos.
En las pruebas en línea, las respuestas medianas de $match fueron de 28 ms con 5 M y 25 ms con 10 M. El 95 % llegó en menos de 56 ms en ambas poblaciones. Las cifras de entrenamiento excluyen la importación de datos y la configuración inicial en línea.
Pruebe el constructor de modelos
Abra Models → Model builder en MDMbox 2610.0 para entrenar su primer modelo. Consulte la documentación o solicite una demostración para hablar con nuestro equipo sobre su flujo de trabajo de emparejamiento de pacientes.
Pruebe las mismas entradas con los ocho conjuntos de datos descargables. Cada uno incluye FHIR Patient NDJSON, su ViewDefinition y un CSV separado con etiquetas de identidad completas, incluidos los singletons. Las etiquetas son para evaluación externa; no son entradas de entrenamiento ni un formato de carga de etiquetas de MDMbox. La documentación de descarga incluye la atribución de fuentes, los términos y las sumas de verificación.
Para una primera prueba pequeña, descargue FEBRL1: datos de pacientes, asignación de campos y etiquetas de evaluación.
Descargue los modelos medidos y los resultados completos de calidad para FEBRL, ePBRN y NC Voters. Los archivos contienen definiciones de modelos y resultados, sin datos de pacientes originales.