

Un Master Patient Index (MPI) es un sistema de base de datos sanitario que identifica de forma única a cada paciente en múltiples registros y sistemas de origen. El acrónimo MPI hace referencia específicamente al subsistema de identidad de pacientes dentro de la Master Data Management (MDM) en el ámbito sanitario. Un MPI consolida registros duplicados, potencia la vinculación de registros y ofrece a los proveedores una visión única y precisa de cada paciente.
También denominado Patient Index o Healthcare Patient Index en algunos contextos, el MPI es la columna vertebral de los sistemas de datos centrados en el paciente. Cuanta más información tienen los proveedores de atención sanitaria sobre un paciente, mejor es la atención que pueden prestar, pero solo si esa información está correctamente vinculada a la persona correcta.
Los protocolos estándar como FHIR, respaldados por las normativas nacionales, facilitan la recopilación de datos de pacientes procedentes de laboratorios, hospitales, centros de diagnóstico, etc. Sin embargo, determinar si distintos registros pertenecen a la misma persona o si contienen datos duplicados puede representar un desafío. Este es el problema central que la Master Data Management (MDM) sanitaria está diseñada para resolver, y el Master Patient Index (MPI) es su subsistema orientado al paciente, combinado con un algoritmo de vinculación de registros adecuado.
En este artículo hablaremos de:
- Qué son el Master Patient Index (MPI) y la vinculación de registros, y cómo encajan en la Master Data Management sanitaria;
- Cómo implementar un MPI y qué métodos se pueden utilizar;
- Cómo elegir el algoritmo de vinculación de registros adecuado.
¿Qué es un Master Patient Index (MPI)?
El Master Patient Index (MPI) es un software utilizado en organizaciones sanitarias para identificar de forma única a cada paciente y consolidar sus múltiples registros. Esto ayuda a garantizar que todos los proveedores de atención sanitaria tengan acceso a información precisa sobre los pacientes.
La vinculación de registros (Record Linkage) es el proceso de concordancia de registros duplicados. El algoritmo de concordancia (método) es el corazón del Master Patient Index. Calcula la similitud entre dos registros y determina si son el mismo.
Consejo: Si busca una herramienta completa para gestionar registros de pacientes, el término «Master Patient Index» es una palabra clave útil para su búsqueda. Si le interesa más entender cómo funciona, siga leyendo el artículo y busque «Record Linkage» más adelante.
Cómo encaja el MPI en la Master Data Management sanitaria
La Master Data Management (MDM) en sanidad es la disciplina que consiste en construir una visión única y de confianza de las entidades de las que depende el resto del sistema: pacientes, proveedores, organizaciones, ubicaciones y pagadores. Cada una de ellas tiene sus propias particularidades, pero el patrón de ingeniería es el mismo: ingerir datos de múltiples sistemas de origen, hacer concordar los registros que hacen referencia a la misma entidad del mundo real y resolver los conflictos en un registro dorado en el que puedan confiar los consumidores de datos posteriores.
El Master Patient Index es la parte específica de ese panorama relativa al paciente. Es, con diferencia, el aspecto más debatido de la MDM sanitaria, porque la identidad del paciente es donde los errores tienen mayor coste: un registro de paciente duplicado fragmenta el historial clínico; un registro fusionado incorrectamente genera un evento de seguridad. Por eso, cuando los equipos hablan de «MPI», casi siempre se refieren a una capacidad de Master Data Management orientada al recurso Patient: la misma maquinaria de concordancia, bloqueo, fusión y auditoría que se utilizaría para cualquier otra entidad maestra, aplicada allí donde el nivel de riesgo es más elevado.
En el resto de este artículo analizaremos cómo funciona realmente esa maquinaria.
Cómo funciona un Master Patient Index
La implementación del Master Patient Index sigue un flujo de trabajo específico, compuesto por varios pasos clave:
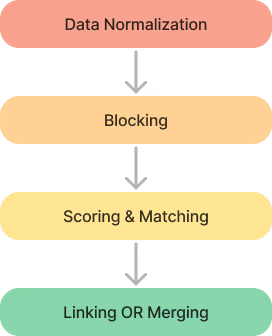
- Limpieza y normalización de datos: limpiar los datos y estandarizar su formato;
- Bloqueo: agrupar previamente los registros para reducir el número de comparaciones y mejorar el rendimiento;
- Puntuación y concordancia: el «corazón» del proceso: identificar la similitud entre registros y llevar a cabo la concordancia automática o manual;
- Vinculación o fusión de registros duplicados.
A continuación examinaremos cada paso con más detalle.
Master Patient Index: Limpieza y normalización de datos
En primer lugar, limpiamos los datos.
Es necesario asegurarse de que los identificadores (como la dirección, el sexo, el número de la seguridad social, etc.) tengan un formato coherente para obtener resultados más precisos. Esto se puede lograr eliminando la puntuación, convirtiendo los textos a mayúsculas y estandarizando los valores.
Normalice las terminologías: mientras que el campo Sexo puede representarse como «Male/Female» en un conjunto de datos y «Man/Woman» en otro, debe codificarse de la misma manera.
Si un valor no es válido y se ha introducido únicamente para cubrir un campo obligatorio (por ejemplo, «Baby boy» en el campo Nombre o «00000000» como número de la seguridad social), se recomienda restablecer el valor a «NULL», ya que el algoritmo puede ser sensible a este tipo de entradas.
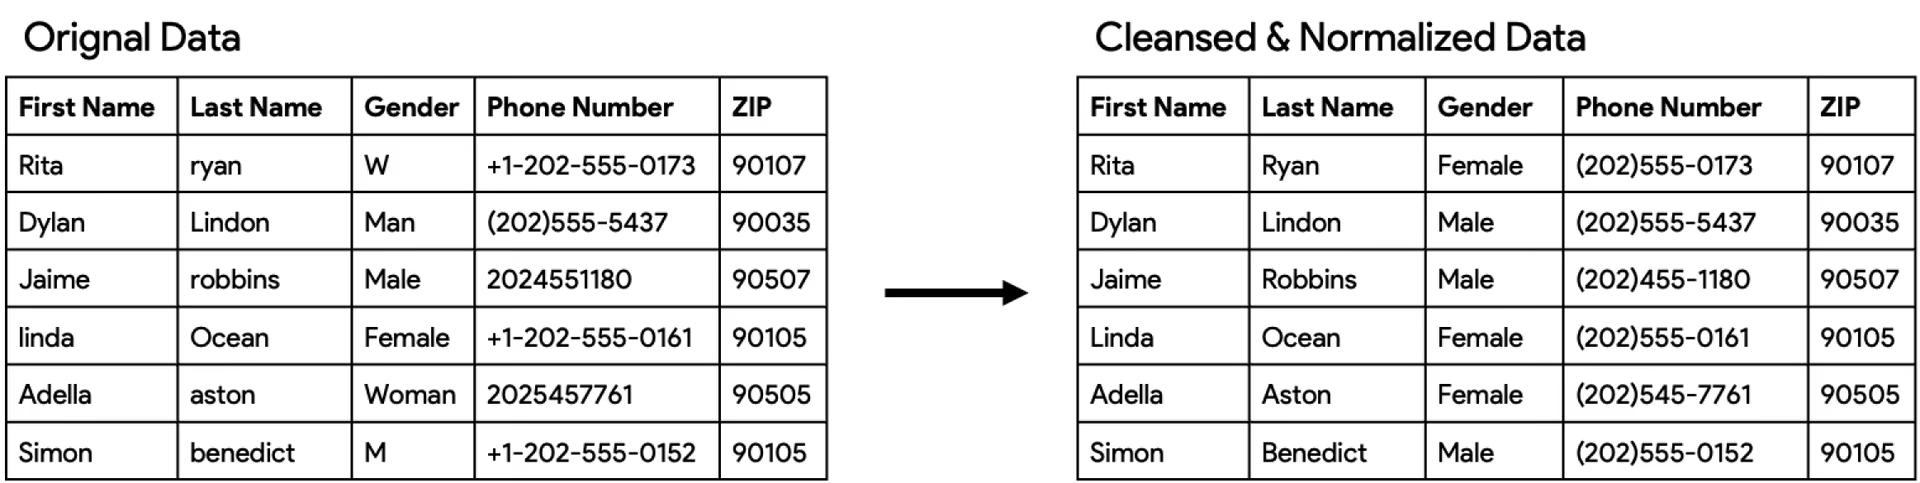
La situación ideal se produce cuando la fuente de datos proporciona datos limpios en el mismo formato (con los mismos nombres de atributos), pero esto no siempre es así y, por lo general, hay que convertir los datos al mismo formato.
Recomendamos utilizar HL7 FHIR para formatos de datos estándar, ya que estamos observando una adopción significativa de FHIR y todo indica que se convertirá en la lengua franca del intercambio de datos sanitarios en un futuro próximo. Nuestra solución de Master Patient Index y Master Data Management, MDMbox, está implementada sobre FHIR.
Master Patient Index: Bloqueo
Una vez que los datos han sido limpiados y normalizados, podemos comenzar el proceso de bloqueo de registros. Si un Master Patient Index contiene un millón de registros, una comparación directa de todos ellos requeriría un billón de comparaciones, pero es posible reducir significativamente ese número.
Esto suele implicar someter el conjunto de datos a una serie de filtros, utilizando en cada ocasión un atributo o método diferente para identificar posibles concordancias, aunque existe un equilibrio entre rendimiento y precisión, y es importante elegir la clave de bloqueo adecuada.
El bloqueo consiste típicamente en dividir los registros en grupos más pequeños —o «bloques»— basándose en determinados criterios (filtros), por ejemplo mediante similitud débil (como nombre, sexo, año de nacimiento, código postal, etc.).
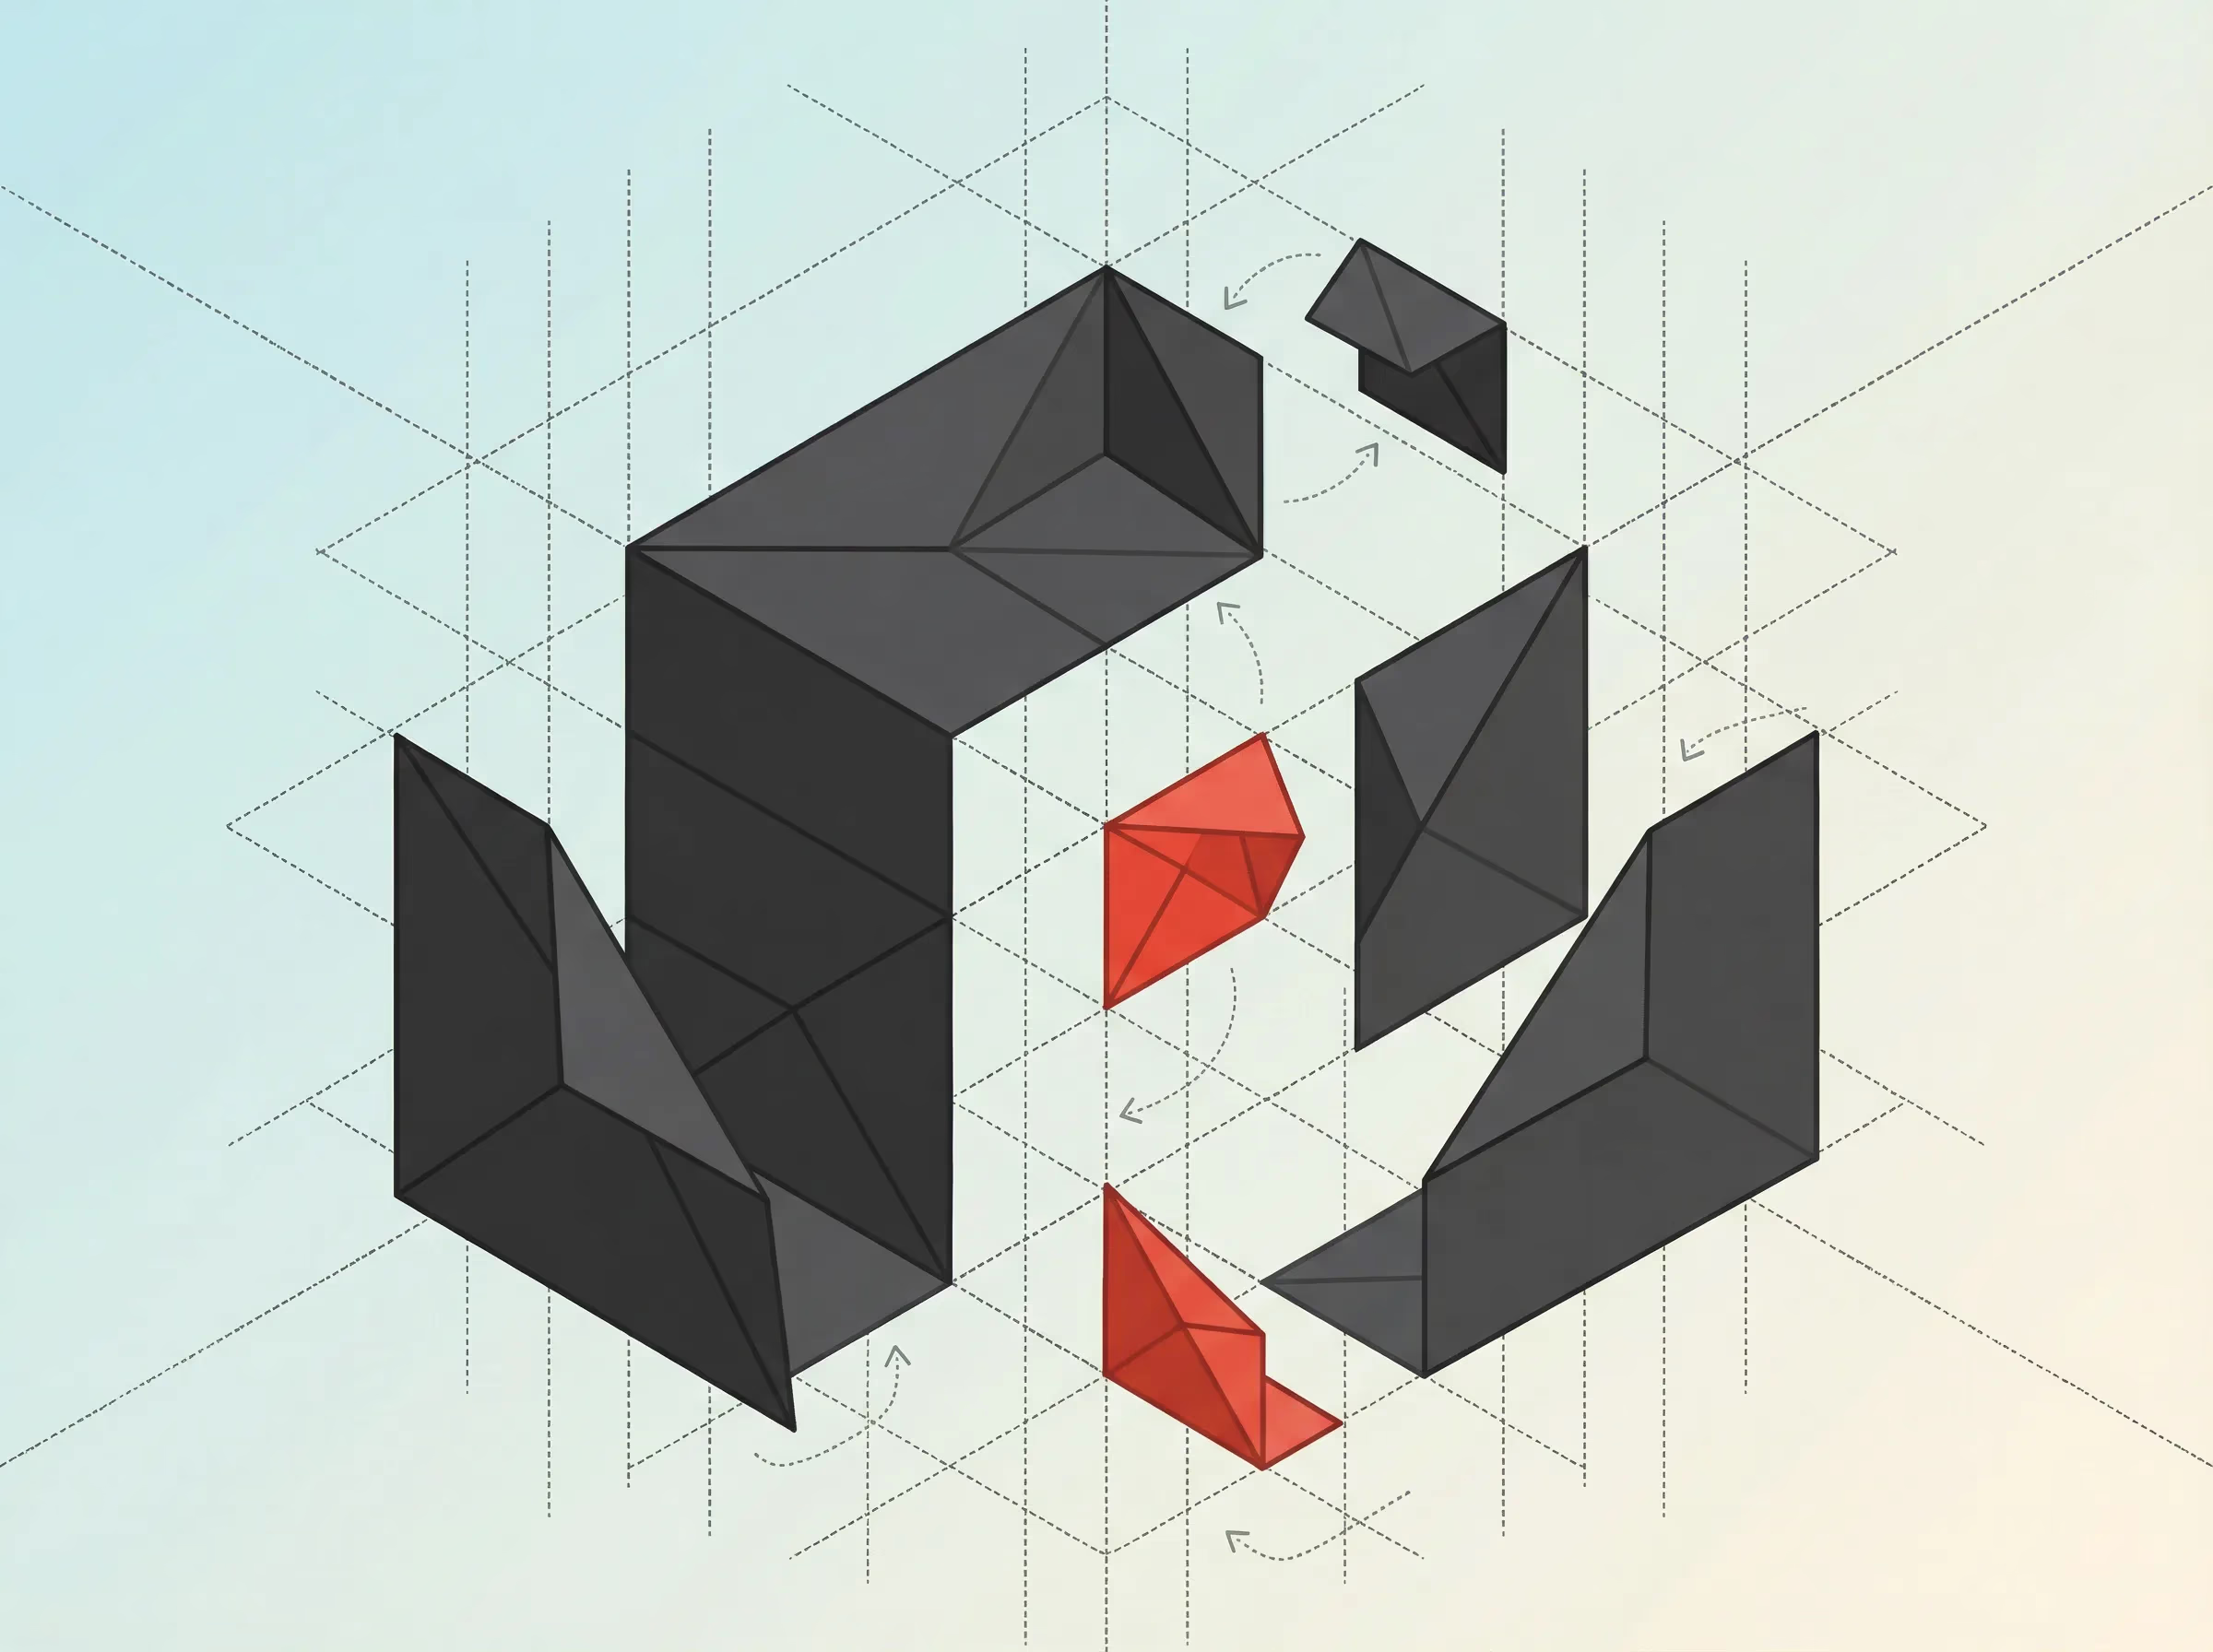
Como se puede observar en el esquema de ejemplo que se muestra a continuación, una operación de bloqueo puede generar bloques candidatos utilizando el atributo Apellido y la primera letra del Nombre, o bien crear bloques a partir de otros atributos, como el Número de teléfono o el Código postal:
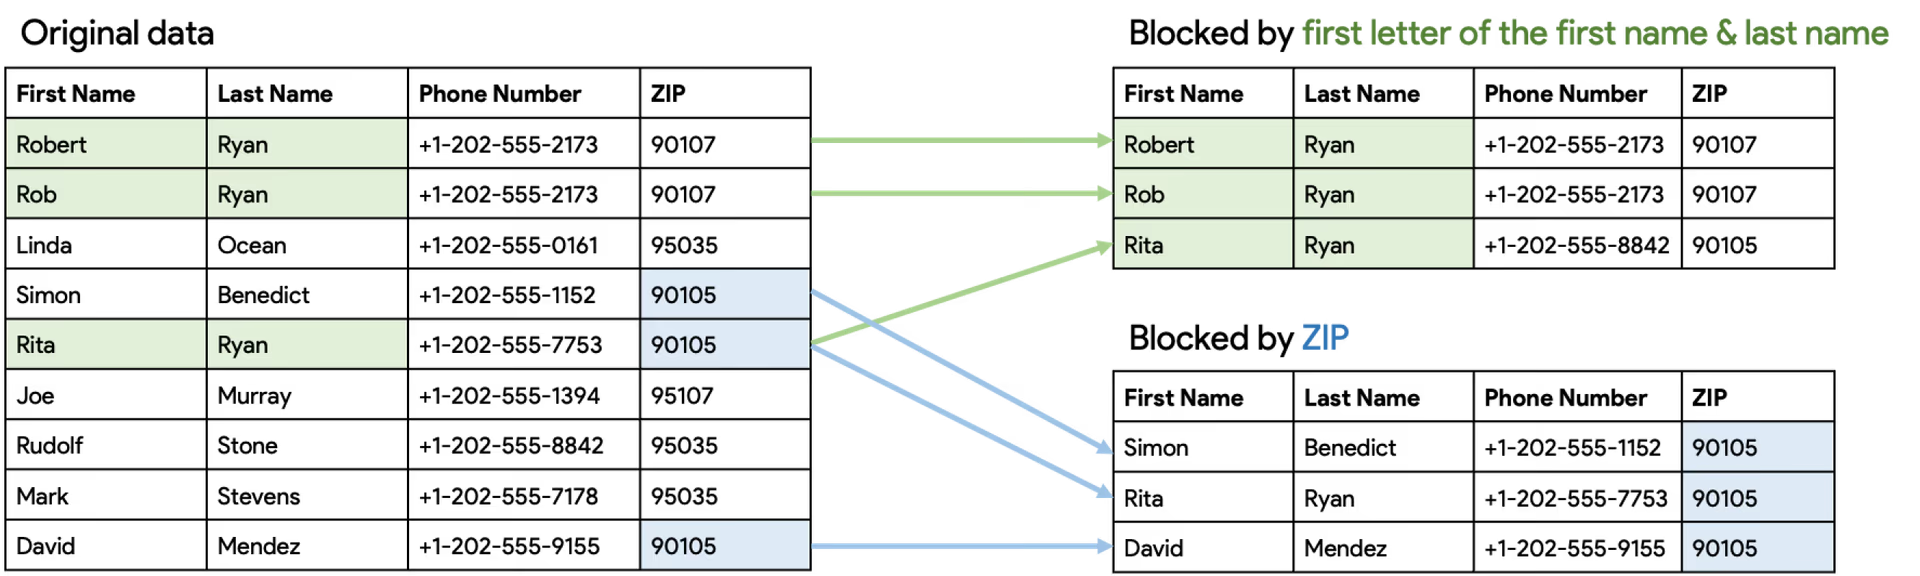
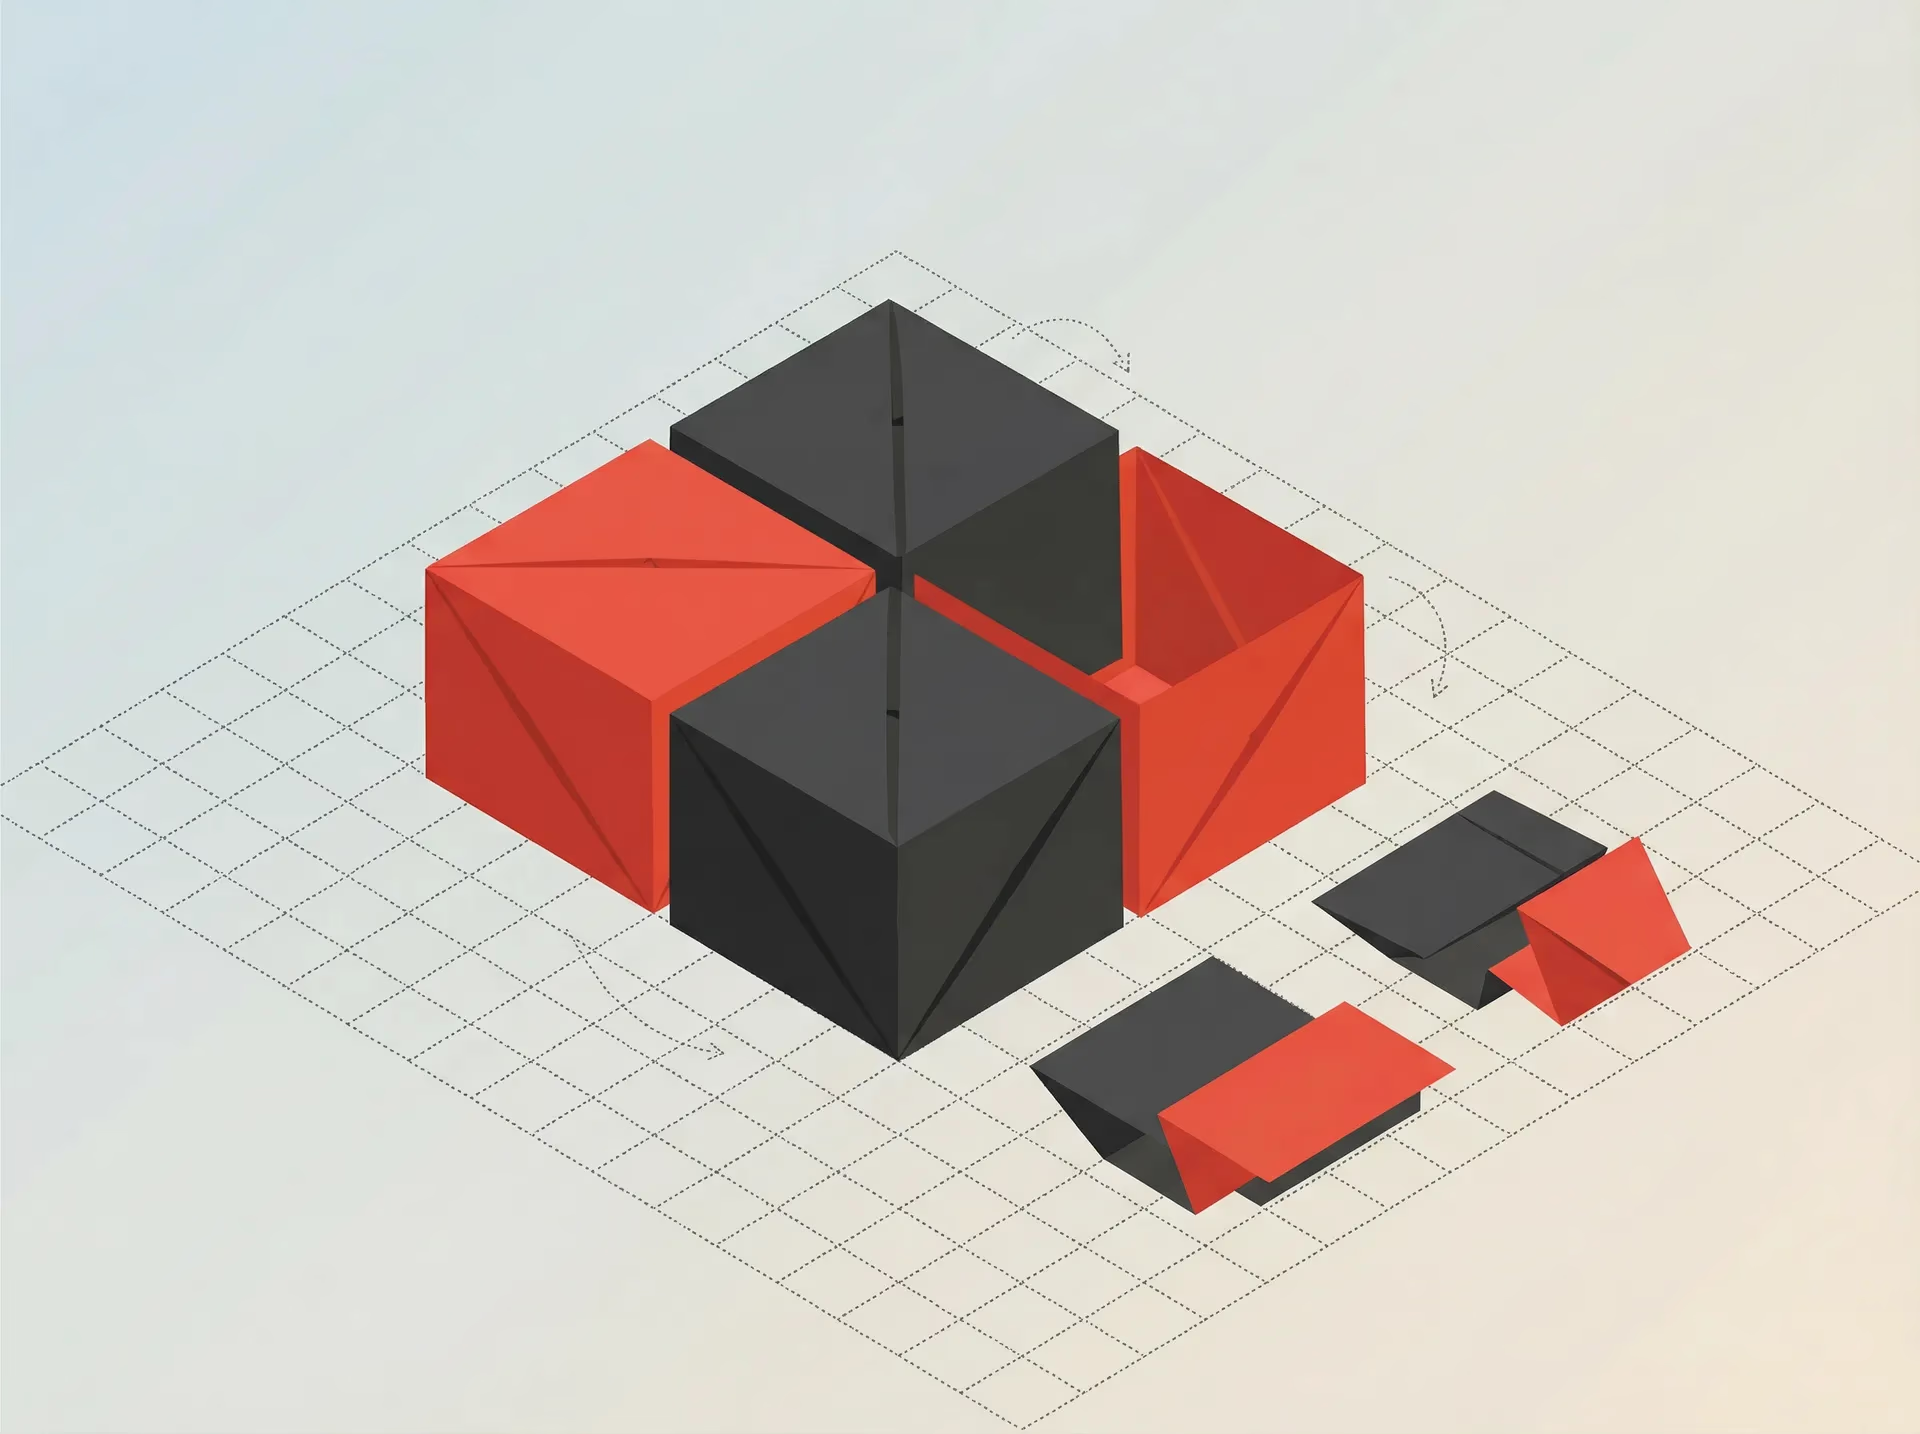
La concordancia se realiza entonces dentro del bloque, o entre dos bloques dentro del mismo atributo:
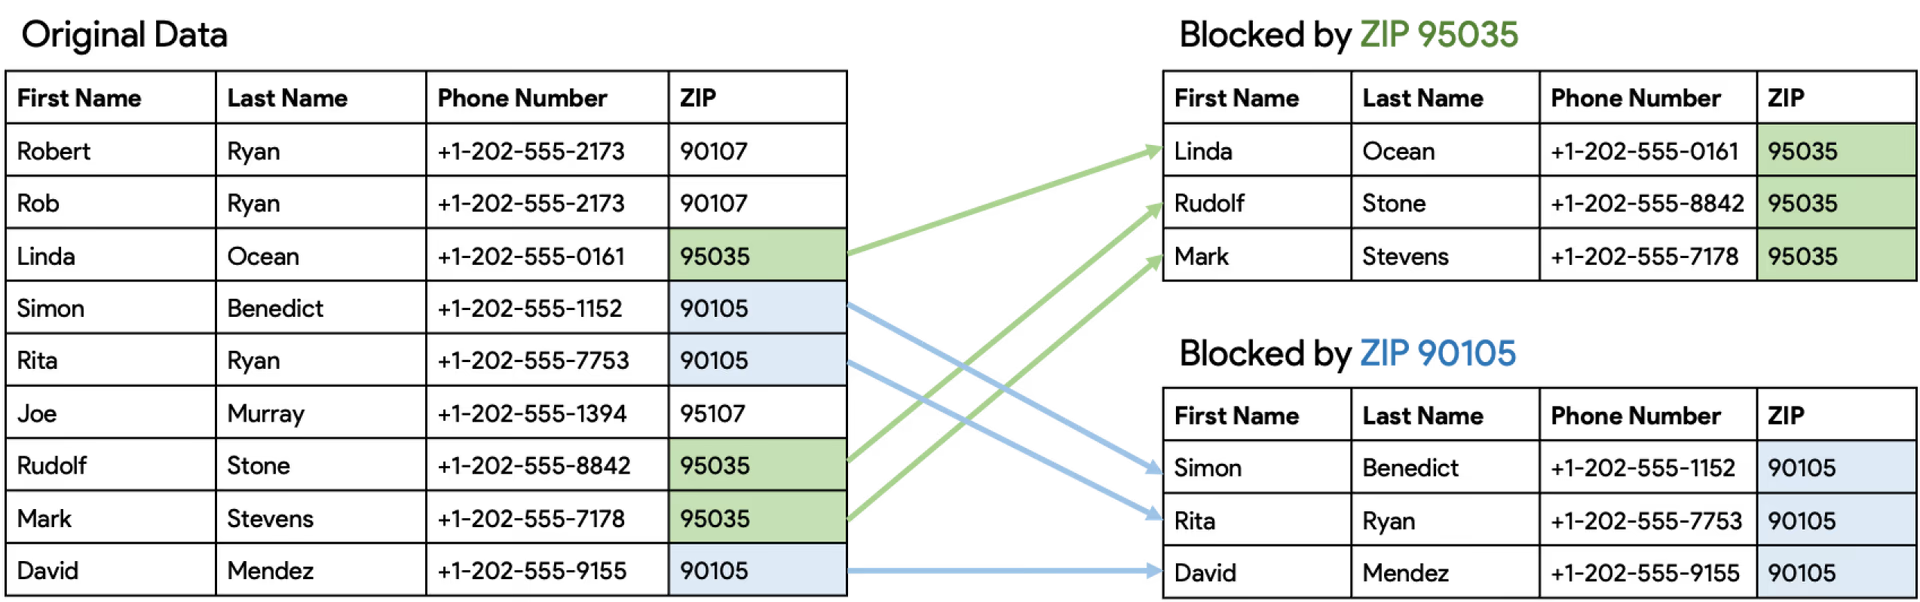
Cabe señalar que distintas ejecuciones de esta operación pueden descubrir concordancias verdaderas diferentes, por lo que combinar los resultados puede potencialmente revelar la mayoría de las concordancias verdaderas.
El objetivo es minimizar el número de candidatos; por tanto, las directrices deben ser:
- Suficientemente amplias para abarcar todos los registros relevantes dentro del mismo bloque;
- Suficientemente específicas para permitir una comparación eficiente de los candidatos en un tiempo razonable.
Master Patient Index: Puntuación y concordancia
El «corazón» del Master Patient Index es el proceso de puntuación y concordancia, y en este paso es fundamental determinar si dos registros hacen referencia con probabilidad a la misma persona. Los algoritmos pueden clasificar los registros en dos grupos —Concordancia o No concordancia— o en un tercer grupo, Posible concordancia, donde la decisión puede delegarse en personas.
La concordancia puede realizarse mediante diferentes métodos:
- Método determinista (basado en reglas): utiliza un conjunto de reglas (por ejemplo, concordancia de número de seguridad social, fecha de nacimiento y apellido) y también se denomina lógica de concordancia exacta. Las reglas deterministas pueden diseñarse con un alto nivel de especificidad;
- Método probabilístico (basado en puntuación o Fellegi-Sunter): este método vincula los registros cuando la suma de todos los acuerdos ponderados supera los desacuerdos.
Puede utilizar esta tabla para comparar los métodos de forma rápida y sencilla:
| Método | Ventajas | Desventajas |
|---|---|---|
| Método determinista (basado en reglas). Utiliza un conjunto de reglas (por ejemplo, concordancia de número de seguridad social, fecha de nacimiento y apellido); también se denomina lógica de concordancia exacta. Las reglas deterministas pueden diseñarse con un alto nivel de especificidad. | Fácil de implementar. Fácil de escribir y comprender sus reglas sencillas. | Precisión limitada o requiere extensiones complejas para mejorarla. Difícil de mantener un conjunto de reglas para una concordancia precisa. Muy sensible a la calidad de los datos. Difícil de implementar eficientemente en conjuntos de datos grandes. No hay manera de cuantificar la calidad del algoritmo. |
| Método probabilístico (basado en puntuación o Fellegi-Sunter). Este método vincula los registros cuando la suma de todos los acuerdos ponderados supera los desacuerdos. | Utiliza todos los puntos de datos disponibles para tomar una decisión (concordancia o no concordancia). Gestiona datos ausentes o no válidos. Puede aprender de estadísticas de datos existentes y nuevos. La calidad del algoritmo (precisión y sensibilidad) puede estimarse en números. Escala bien con el bloqueo para grandes conjuntos de datos. Utilizado con éxito en el análisis de poblaciones en numerosos proyectos. | Requiere configuración y ajuste por parte de expertos. |
MDMbox utiliza el método probabilístico (modelo basado en el algoritmo Fellegi-Sunter), que es un tipo de clasificador bayesiano, y compara los valores de atributos específicos como el nombre, la fecha de nacimiento o el número de la seguridad social. Si los atributos parecen ser los mismos, aumenta la probabilidad de concordancia; si los atributos no coinciden, la probabilidad de concordancia disminuye.
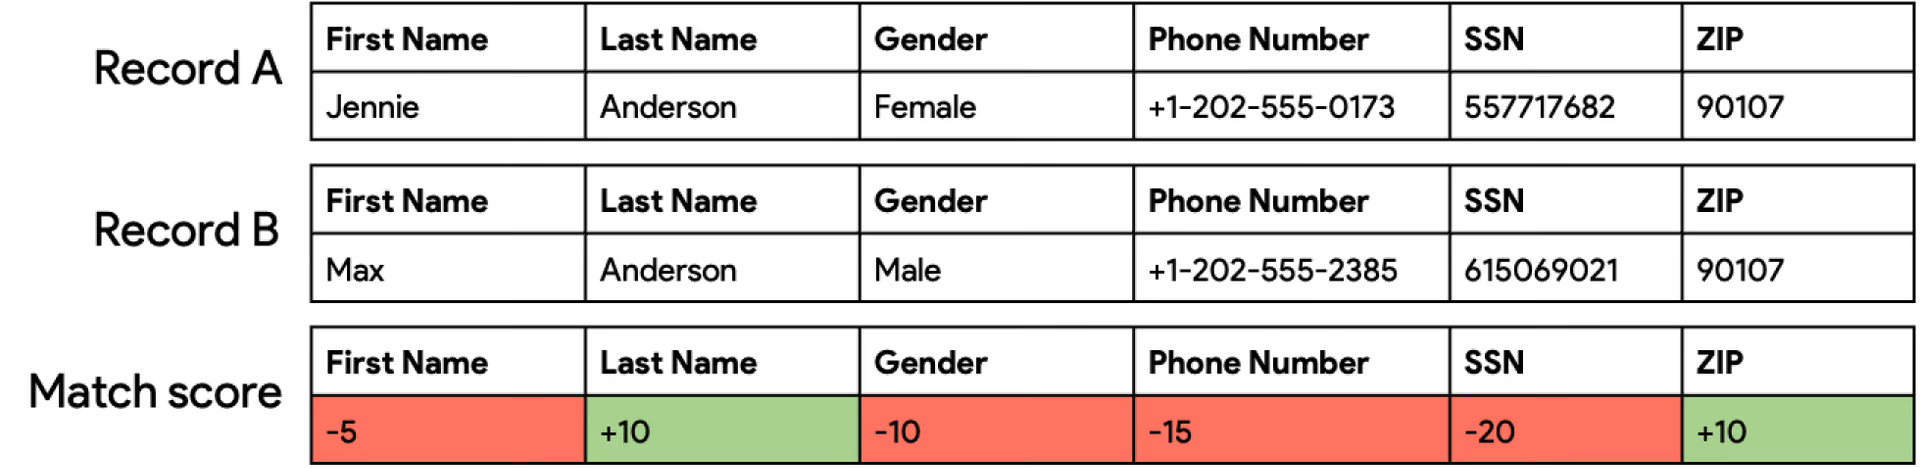
Así pues, utilizamos un sistema que nos ayuda a determinar la probabilidad de que dos registros sean el mismo. Comenzamos estimando la probabilidad de que dos registros seleccionados al azar coincidan. Luego comparamos los registros para ver si tienen elementos en común, como la misma fecha de nacimiento, número de seguridad social o número de teléfono.
A continuación, una forma sencilla de explicar cómo funciona el algoritmo: compara registros y evalúa con precisión la evidencia, de modo que podemos determinar la probabilidad de una concordancia:
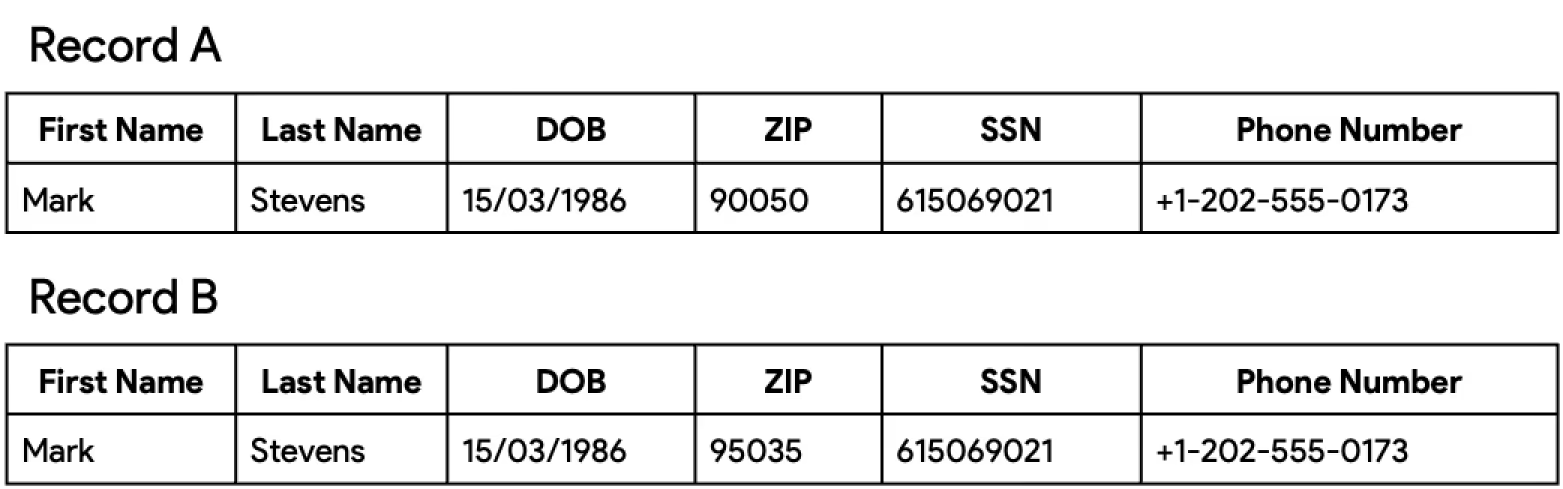
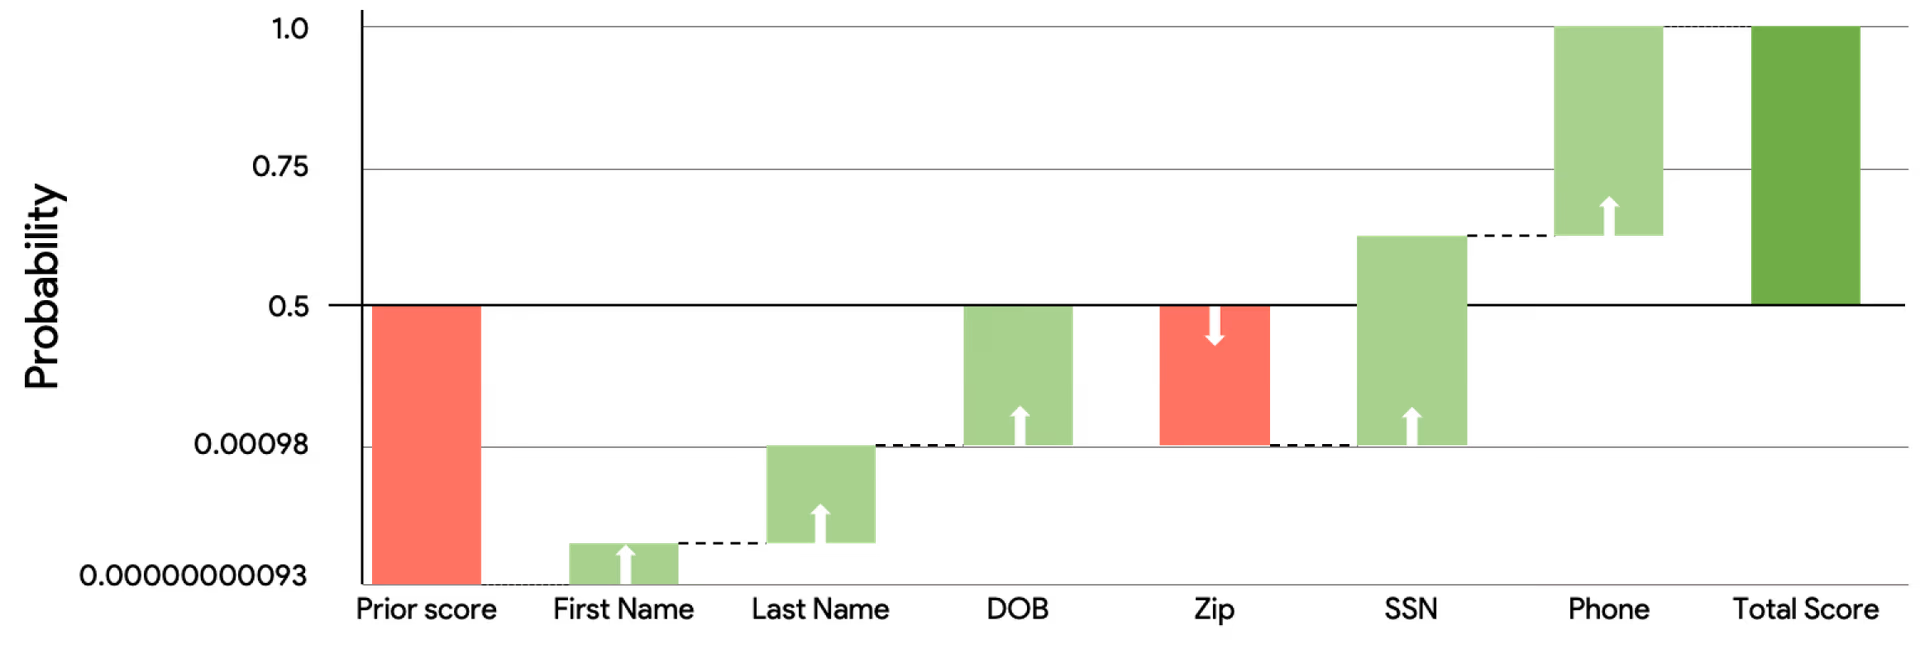
- Las columnas con un mayor número de valores únicos, como la fecha de nacimiento, el número de la seguridad social o el número de teléfono, tienen más probabilidades de establecer una concordancia sólida, ya que es poco probable que estos valores en dos registros seleccionados aleatoriamente coincidan por azar.
- Cuando una columna no coincide, suele ser evidencia en contra de una concordancia. También hay que admitir que esta evidencia puede no ser del todo fiable en casos donde factores externos, como un cambio de nombre por matrimonio, un cambio de domicilio que daría lugar a un código postal diferente para el paciente, o un simple error tipográfico en la introducción de datos, pueden generar una discrepancia en la columna.
Si esta puntuación de evidencia total alcanza o supera un umbral configurable, conocido como valor de corte, los registros se consideran concordantes y pueden vincularse. Si la puntuación cae por debajo del umbral, los registros se consideran individuos distintos y no se vinculan en el Master Patient Index.
Una práctica habitual es examinar la distribución de las puntuaciones y elegir un método de similitud que produzca la tasa deseada de falsos positivos o falsos negativos. Esto puede ayudar a equilibrar la necesidad de precisión con la de minimizar la carga de trabajo de los revisores humanos. Para una guía práctica sobre esta calibración, consulte nuestra guía sobre configuración y ajuste de un modelo de concordancia de pacientes.
Comience con el Aidbox FHIR Server para el almacenamiento de datos, integraciones, analítica sanitaria y mucho más, o contrate a nuestro equipo para respaldar sus necesidades de desarrollo de software.
Elección del algoritmo de concordancia
Como opción predeterminada, Fellegi-Sunter parece ser la más adecuada. Requiere que un experto lo configure y ajuste, pero puede ofrecer buenos resultados.
Si dispone de menos fuentes de datos de confianza con relaciones estrechas, bastará con reglas deterministas simples, aunque no existe forma de evaluar su precisión.
¿Vincular o fusionar?
Una vez que los registros han sido vinculados por concordancia, es importante decidir si se deben vincular o fusionar.
- Vincular los registros significa que mantenemos todos los registros duplicados tal como están, pero los enlazamos entre sí. Si dispone de distintas fuentes para cada duplicado, no habrá problemas para actualizar los registros.
Esto resulta útil en los casos en que los datos se agregan continuamente de distintas fuentes, ya que permite al Master Patient Index mantener un seguimiento de las relaciones entre registros sin necesidad de resolver continuamente conflictos de fusión.
- Fusionar los registros significa combinarlos en un único registro híbrido.
Esto implica combinar los datos de múltiples registros en un único registro que contenga toda la información relevante sobre un paciente. En comparación con la vinculación, la fusión permite una recuperación de datos más sencilla y rápida, así como un uso de la memoria más eficiente.
Sin embargo, puede resultar más complejo gestionar los conflictos de fusión y los vínculos de falsos positivos en este tipo de sistema.
Mejore la interoperabilidad con soluciones sanitarias HL7 FHIR: CapMinds FHIR Service
El equilibrio del MPI: precisión frente a coste
Si los datos se agregan continuamente de distintas fuentes, la estrategia de vinculación parece preferible, ya que no es necesario resolver continuamente los conflictos de fusión, y los vínculos de falsos positivos pueden revertirse simplemente desvinculándolos.
Por otro lado, este sistema no solo trata con un único registro de paciente, y la mayoría de las interacciones trabajan con conjuntos de registros.
En los sistemas del mundo real, es habitual utilizar un enfoque híbrido que combine tanto la vinculación como la fusión. Esto se debe a que el problema del equilibrio entre mantener la integridad de los datos y permitir consultas flexibles, por un lado, y crear una imagen completa y precisa de los datos, por otro, no tiene solución absoluta.
La hibridación hace que el sistema en su conjunto sea más complejo, pero conduce al resultado deseado. Por ejemplo, un sistema podría vincular primero los registros concordantes para crear una relación entre ellos y, posteriormente, fusionar los registros vinculados en un único registro consolidado.
Alternativamente, un sistema podría fusionar primero los registros concordantes y luego vincular los registros consolidados resultantes.
El equilibrio a la hora de elegir entre vinculación y fusión depende de los objetivos y requisitos específicos del sistema. Si la prioridad es mantener la integridad de los datos y permitir consultas flexibles, es preferible la vinculación. Si la prioridad es crear una imagen completa y precisa de los datos, es preferible la fusión.
Para experimentar con la implementación de un Master Patient Index y la concordancia de registros, pruebe la versión de desarrollo gratuita de MDMbox. Ofrece un entorno completo para probar estas funcionalidades, proporcionando todas las herramientas necesarias sin ninguna limitación.
Conclusión
Hay varios puntos clave a tener en cuenta al implementar un Master Patient Index como parte de su estrategia de Master Data Management sanitaria:
- Asegúrese de que los datos utilizados sean de buena calidad e integridad; en caso contrario, deben limpiarse y normalizarse;
- Elija el algoritmo más adecuado en función de todos los requisitos específicos de su proyecto y la calidad de los datos disponibles;
- Establezca el equilibrio entre fusionar o vincular registros, o cree un sistema híbrido;
- Trate el MPI como una entidad dentro de un programa más amplio de Master Data Management: las mismas primitivas de concordancia, fusión y auditoría se extienden a proveedores, organizaciones y ubicaciones.
Nuestro MDMbox utiliza el método probabilístico basado en el algoritmo Fellegi-Sunter, ya que ha demostrado ser muy eficaz para obtener resultados precisos y eficientes. Este algoritmo ha sido ampliamente estudiado, optimizado para su uso con bases de datos relacionales (SQL) y ha demostrado un rendimiento excepcional en grandes conjuntos de datos.
En MDMbox, las operaciones de concordancia y fusión de pacientes se ejecutan en milisegundos, incluso a escala. La deduplicación masiva es igualmente eficiente: por ejemplo, identificar todos los candidatos duplicados en un conjunto de datos de 5 millones de pacientes lleva aproximadamente 20 minutos. Para ver un ejemplo real, consulte cómo encontramos miles de registros duplicados en el registro NPI utilizando el mismo enfoque.
Además, MDMbox proporciona una interfaz de usuario integrada para el administrador de datos (Data Steward UI), que permite a los equipos revisar y resolver conflictos de fusión, gestionar posibles duplicados y hacer seguimiento de los registros de auditoría completos de fusiones y desvinculaciones para una transparencia y un control totales. Más información
Autores: Nikolai Ryzhikov, CTO en Health Samurai Ivan Shukshin, Ingeniero de Software Principal en Health Samurai
Véase también: Registros de pacientes duplicados en analítica sanitaria, Proveedores de MPI y semántica de $merge de pacientes, Datos sintéticos en sanidad y FHIR como formato de almacenamiento de datos.