

Pourquoi un seul serveur pour deux versions
R6 en est à ses derniers scrutins, et la question a changé. Ce n'est plus « quoi de neuf dans R6 », mais « combien de temps le ferons-nous coexister avec R4 ». Tout ce que nous savons indique : pendant des années.
- La réglementation fixe les versions. La certification américaine (US Core) et les règles d'interopérabilité de CMS pour l'accès aux patients, l'accès aux prestataires, l'échange entre payeurs et l'autorisation préalable reposent toutes sur R4. Les nouvelles règles viendront avec des fenêtres de transition, et non une date de bascule. Les autres pays avancent selon leurs propres échéanciers.
- Les partenaires ne font pas leur mise à niveau en même temps. Si vous êtes une plateforme, un HIE ou un payeur, vous héritez de l'union de toutes les versions de vos partenaires.
- Les longues queues de migration sont normales. Epic sert encore DSTU2, STU3 et R4, chacun à sa propre URL de base. Oracle Health aurait fait fonctionner DSTU2 aux côtés de R4 pendant environ six ans avant de le retirer en 2025.
- R5 a été largement sauté. Les systèmes en production sont restés sur R4 et ont adopté les fonctionnalités R5 dont ils avaient besoin, comme les abonnements basés sur les sujets, via des IGs de rétrocompatibilité R4. Le saut réaliste est donc R4 directement vers R6, avec tous les changements R4 → R5 et R5 → R6 d'un seul coup.
- Les données survivent aux versions. Les dossiers créés aujourd'hui seront consultés dans dix ou vingt ans. Les archives et les pistes d'audit ne sont pas réécrites.
Les changements ne sont pas non plus cosmétiques. Quelques-uns que nous avons rencontrés :
| R4 | R6 | Pourquoi c'est problématique |
|---|---|---|
Encounter.class : un seul Coding | Encounter.class : une liste de CodeableConcept | Plusieurs classes ne tiennent pas dans une seule |
Encounter.status finished, onleave, arrived | completed, on-hold, in-progress + subjectStatus | Codes différents, sans correspondance biunivoque |
Encounter.period, hospitalization, participant.individual | actualPeriod, admission, participant.actor | Renommages |
BodyStructure.location et morphology : un de chaque | BodyStructure.includedStructure : un ou plusieurs | Une ressource R6 peut décrire ce que R4 nécessite plusieurs ressources pour représenter |
Observation.bodySite : un code | ajoute Observation.bodyStructure : une référence | R4 n'a pas d'élément pour stocker le lien |
La coexistence est donc inévitable. La vraie question est de savoir comment la gérer au sein d'un seul système.
Ce que la salle a dit au FHIR Camp
Au HL7 FHIR Camp 2026 à Cascais, au Portugal, j'ai animé une session Birds-of-a-Feather intitulée Coexistence de plusieurs versions FHIR dans le même système. La question : un seul système devrait-il servir plusieurs versions à partir d'un seul jeu de données avec des convertisseurs, ou conserver une copie distincte par version, ou stocker chaque ressource dans la version dans laquelle elle est arrivée ?
La réponse de la salle était claire : les gens veulent un seul jeu de données. Les raisons sont pratiques :
- Une seule source de vérité. Un patient existe une seule fois. Avec une copie par version, les copies divergent, et quelqu'un doit décider laquelle est correcte.
- Pas de conflits entre versions. Si une copie R4 et une copie R6 acceptent toutes deux des écritures, deux clients peuvent modifier le même dossier en même temps via des versions différentes. Les synchroniser entraîne des conflits, des problèmes d'ordonnancement et des règles de fusion. Avec un seul dépôt, chaque écriture va dans la même rangée, et
If-Matchfonctionne quelle que soit la version utilisée par le client. - Un seul historique et une seule piste d'audit. Les versions, suppressions et provenances sont enregistrées une seule fois, pas une fois par copie.
- Un seul endroit pour rechercher et analyser. Les requêtes n'ont pas besoin de savoir dans quelle version une ressource est arrivée.
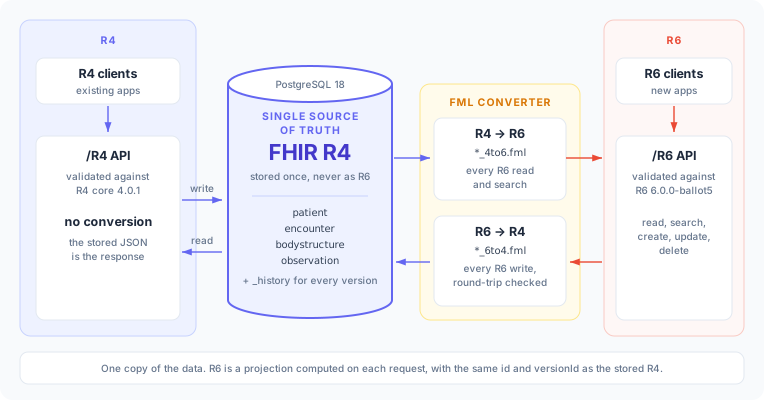
Il ne reste qu'une conception possible : un seul dépôt, avec chaque version servie comme une projection de celui-ci. Cela concentre aussi toute la difficulté en un seul endroit : la conversion. Elle doit fonctionner dans les deux sens, sur des données réelles, à chaque requête.
Un projet de hackathon
Nous en avons donc fait un projet de hackathon, avec deux objectifs : voir jusqu'où va la conception à jeu de données unique, et évaluer si le FHIR Mapping Language (FML) est un moteur de correspondance adapté à cette architecture.
L'équipe : Brian Postlethwaite, Artur Kurvits, Patrick Werner, Francisco Novillo Perez, Vadim Peretokin, Ralf Pohl et Aleksandr Kislitsyn.
Un merci tout particulier à Gino Canessa. Il ne faisait pas partie de l'équipe, mais il a partagé certains des cas les plus difficiles, ceux qu'il est difficile de traiter correctement.
La configuration
Le serveur est intentionnellement minimaliste :
- Un seul dépôt, FHIR R4 uniquement. PostgreSQL 18, une table par type de ressource plus une table d'historique. Nous avons choisi R4 parce que c'est là que se trouvent les données et les clients actuels. Avec R6 comme dépôt, les mêmes conversions s'effectueraient simplement dans l'autre sens.
- Deux API.
/R4lit et écrit le JSON stocké sans conversion./R6lit, recherche, crée, met à jour et supprime via le FHIR Mapping Language (FML). - Le moteur FML est l'exécuteur FML de Brian Postlethwaite issu de FHIRPath Lab. Il exécute ses cartes R4 → R6 générées sans modification, importations comprises : 164 cartes. La direction R6 → R4 comporte 63 cartes : les types de données inversés par rapport aux cartes générées, plus des cartes écrites à la main pour Patient, Encounter, BodyStructure et Observation.
- La validation utilise R4 4.0.1 et R6 6.0.0-ballot5, chargés avec
@atomic-ehr/fhir-canonical-manageret vérifiés avec@atomic-ehr/fhirschema.
Une règle cimente le tout : chaque écriture, quelle que soit la version, doit être valide dans les deux versions et survivre à l'aller-retour R6 → R4 → R6.
Chaque réponse R6 porte le même id et versionId que la ressource R4 stockée, de sorte que les deux versions s'accordent toujours sur le dossier et la version consultés.
Patient : le cas facile
Patient est normatif depuis R4 et a peu changé. La carte générée est une copie champ par champ, et elle fonctionne sans modification. R6 ajoute trois éléments à Patient.contact : role, additionalName et additionalAddress. À l'entrée dans R4, ils sont placés dans des extensions inter-versions, et ils en ressortent à la sortie vers R6.
Ce patron revient tout au long du projet, et vaut la peine d'être énoncé une fois pour toutes. FHIR définit un schéma d'URL pour les extensions inter-versions, http://hl7.org/fhir/[version]/StructureDefinition/extension-[element], pour les données qui n'ont pas de place dans l'autre version. http://hl7.org/fhir/6.0/StructureDefinition/extension-Patient.contact.role est le Patient.contact.role de R6, stocké en R4.
Encounter : là où les versions diffèrent vraiment
Un client R6 crée un Encounter avec deux classes et un statut « completed » :
POST /R6/Encounter

{
  "resourceType": "Encounter",
  "status": "completed",
  "class": [
    { "coding": [{
        "system": "http://terminology.hl7.org/CodeSystem/v3-ActCode",
        "code": "AMB" }] },
    { "coding": [{
        "system": "http://terminology.hl7.org/CodeSystem/v3-ActCode",
        "code": "VR" }] }
  ],
  "participant": [{ "actor": { "reference": "Practitioner/dr-smith" } }],
  "actualPeriod": { "start": "2026-11-06T09:00:00Z", "end": "2026-11-06T09:30:00Z" },
  "admission": { "admitSource": { "text": "Referral" } }
}
Le Encounter_6to4.fml écrit à la main le transforme en R4. Les codes de statut suivent le ConceptMap R5 → R4 de HL7, puisque R5 et R6 les partagent. La première classe devient la class R4, chaque classe supplémentaire devient une extension inter-versions, et les éléments renommés retrouvent leurs noms R4 :
conceptmap "EncounterStatus" {
  s:"planned"   - t:"planned"
  s:"on-hold"   - t:"onleave"
  s:"completed" - t:"finished"
  …
}

group Encounter(source src : EncounterR6, target tgt : EncounterR4) extends DomainResource <<type+>> {
  src.status as v where ($this != 'in-progress' and $this != 'discharged')
    -> tgt.status = translate(v, '#EncounterStatus', 'code');
  src.class first as c -> tgt.class as k then EncounterFirstClass(c, k);
  src.class not_first as v -> tgt.extension as x,
    x.url = 'http://hl7.org/fhir/6.0/StructureDefinition/extension-Encounter.class',
    x.valueCodeableConcept as t then CodeableConcept(v, t);
  src.actualPeriod -> tgt.period;                       // renamed
  …
}
Voici ce qui est stocké et ce qu'un client R4 lit :
{
  "resourceType": "Encounter",
  "status": "finished",
  "class": {
    "system": "http://terminology.hl7.org/CodeSystem/v3-ActCode",
    "code": "AMB"
  },
  "extension": [{
    "url": "http://hl7.org/fhir/6.0/StructureDefinition/extension-Encounter.class",
    "valueCodeableConcept": {
      "coding": [{
        "system": "http://terminology.hl7.org/CodeSystem/v3-ActCode",
        "code": "VR"
      }]
    }
  }],
  "participant": [{ "individual": { "reference": "Practitioner/dr-smith" } }],
  "period": { "start": "2026-11-06T09:00:00Z", "end": "2026-11-06T09:30:00Z" },
  "hospitalization": { "admitSource": { "text": "Referral" } }
}
La relecture via /R6 retourne exactement ce que le client a envoyé, plus id et meta. La vérification de l'aller-retour le garantit avant que l'écriture soit acceptée.
La traduction de statuts est-elle avec perte ?
translate() seul n'est sûr que là où les codes se correspondent biunivoquement. R6 possède plus de codes de statut Encounter que R4, ce qui fait que certains se regroupent :
| Statut R6 | Statut R4 | Avec perte avec translate() seul ? |
|---|---|---|
completed | finished | Non |
on-hold | onleave | Non |
discharged | finished | Oui : finished se relit comme completed |
discontinued | aucun code R4 | Oui : rien vers quoi traduire |
Pour un cas plusieurs-vers-un comme discharged, la carte stocke le code R4 le plus proche et conserve le code R6 original dans une extension inter-versions sur l'élément lui-même. C'est la règle HL7 pour les liaisons requises avec des codes supplémentaires :
{
  "status": "finished",
  "_status": {
    "extension": [{
      "url": "http://hl7.org/fhir/6.0/StructureDefinition/extension-Encounter.status",
      "valueCode": "discharged"
    }]
  }
}
Un client R4 voit un statut R4 valide. La direction R6 vérifie d'abord l'extension, de sorte que discharged revient comme discharged, et non comme completed. L'approche générale est donc : traduire là où les codes correspondent, et lorsqu'ils ne correspondent pas, conserver la valeur d'origine à côté de la valeur traduite.
discontinued n'est pas encore résolu. Il n'a aucun code R4, donc pour l'instant une écriture qui l'utilise est rejetée plutôt que stockée avec un statut deviné.
La recherche a un sens différent selon la version
L'Encounter stocké a maintenant la classe AMB de façon native et VR dans une extension. Quelles recherches devraient le trouver par VR ?
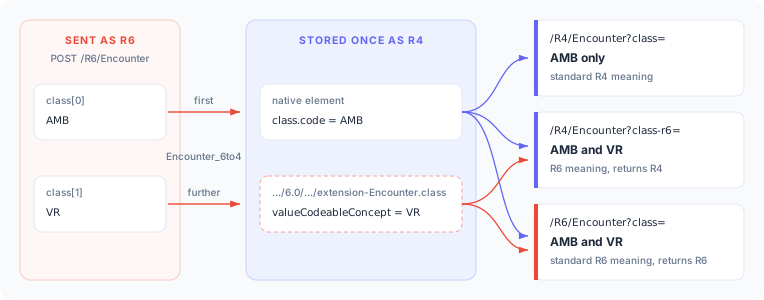
Pour R6, la réponse est simple : class est une liste, VR en fait partie, donc class=VR correspond. La question est ce que class en R4 devrait faire.
Option 1 : donner à class R4 la signification R6. Nous aurions pu faire en sorte que le paramètre R4 cherche aussi dans l'extension inter-versions. Les deux versions retourneraient alors les mêmes Encounters pour la même requête. Mais voyez ce qu'un client R4 reçoit : il demande class=VR, et reçoit un Encounter dont la class est AMB. La valeur recherchée ne figure pas dans le champ que porte le nom du paramètre. Elle est dans une extension que le client ne lit peut-être même pas. La recherche contredirait la forme des données que le client voit.
Option 2 : conserver la signification standard. class en R4 ne correspond qu'à ce qui figure dans class R4, donc il trouve l'Encounter par AMB et non par VR. Les résultats sont cohérents avec la ressource que reçoit le client R4, et les paramètres standard conservent leur définition publiée. Le coût : les mêmes données stockées répondent différemment à la même question selon la version par laquelle on les interroge.
Nous avons choisi l'option 2, et avons ajouté un paramètre explicite pour les clients R4 qui veulent le comportement R6 :
- R6
classcorrespond àAMBetVR: la signification R6 standard. - R4
classcorrespond uniquement àAMB: la signification R4 standard. - R4
class-r6correspond àAMBetVR: la signification R6, optée explicitement par son nom, retournant des ressources R4.
Est-ce la meilleure réponse ? Je ne suis pas sûr qu'il en existe une. Une application R4 qui affiche ce qui est dans class veut l'option 2. Un rapport qui doit comptabiliser chaque visite virtuelle, quelle que soit la version dans laquelle elle a été écrite, veut la signification R6. Chaque implémenteur devra décider selon son propre cas d'utilisation. Ce qui importe, c'est de choisir délibérément et de rendre le choix visible aux clients plutôt que de le cacher dans un paramètre standard.
Nous avons défini class-r6 comme un SearchParameter R4 approprié dans un petit paquet FHIR local. Le gestionnaire canonique le charge aux côtés du noyau R4, le serveur le sert à /R4/SearchParameter/Encounter-class-r6, et le CapabilityStatement y pointe :
{
  "resourceType": "SearchParameter",
  "url": "http://example.org/fhir/SearchParameter/Encounter-class-r6",
  "derivedFrom": "http://hl7.org/fhir/SearchParameter/Encounter-class",
  "code": "class-r6",
  "base": ["Encounter"],
  "type": "token",
  "expression": "Encounter.class | Encounter.class.extension('http://hl7.org/fhir/6.0/StructureDefinition/extension-Encounter.class').value | Encounter.extension('http://hl7.org/fhir/6.0/StructureDefinition/extension-Encounter.class').value"
}
La recherche elle-même s'exécute en SQL sur le R4 stocké. FML ne convertit que les résultats pour /R6.
BodyStructure : une ressource, plusieurs rangées
BodyStructure est l'endroit où les deux modèles cessent de s'aligner. Dans R6, includedStructure est une liste : un seul BodyStructure peut décrire une lésion couvrant l'avant-bras, le bras supérieur et l'épaule. R4 n'a qu'un seul location et un seul morphology.
Notre réponse, qui est notre propre conception et non celle de HL7, est de stocker un BodyStructure R6 en tant que une ressource R4 par structure, avec les identifiants abc, abc--2, abc--3. Une extension gérée par le serveur les relie : la première rangée liste les autres, et chaque autre rangée pointe vers la première.
GET /R4/BodyStructure/abc

{
  "resourceType": "BodyStructure",
  "id": "abc",
  "location": { "text": "Forearm" },
  "extension": [{
    "url": "http://example.org/fhir/StructureDefinition/bodystructure-row-group",
    "extension": [
      { "url": "position", "valuePositiveInt": 1 },
      { "url": "member", "valueReference": { "reference": "BodyStructure/abc--2" } },
      { "url": "member", "valueReference": { "reference": "BodyStructure/abc--3" } }
    ]
  }]
}
Le reste en découle :
- Une écriture réécrit l'ensemble des rangées en une seule transaction, quelle que soit la version.
- Les valeurs propres à R6 vont dans des extensions inter-versions, comme les morphologies supplémentaires, la latéralité et les repères anatomiques.
- Les identifiants de rangée restent stables, et l'
includedStructure.idR6 de chaque structure correspond à son numéro de rangée. - R6 ne montre que
abc.GET /R6/BodyStructure/abc--2retourne un404.
Il existe une autre façon de scinder, qui est peut-être la plus claire. Numéroter chaque structure, abc--1, abc--2, abc--3, et ne pas stocker de ressource R4 appelée abc du tout. Une lecture de GET /R4/BodyStructure/abc retourne alors un OperationOutcome qui liste les véritables identifiants :
GET /R4/BodyStructure/abc

{
  "resourceType": "OperationOutcome",
  "issue": [{
    "severity": "information",
    "code": "informational",
    "diagnostics": "BodyStructure/abc is stored in R4 as three resources: BodyStructure/abc--1, BodyStructure/abc--2, BodyStructure/abc--3"
  }]
}
Les compromis jouent dans les deux sens :
abc, abc--2, abc--3 (ce que nous avons construit) | abc--1, abc--2, abc--3 + OperationOutcome | |
|---|---|---|
Lecture de abc via R4 | Retourne la première structure, qui ressemble à l'ensemble | Indique clairement que c'est scindé, et où se trouvent les parties |
Références R4 existantes vers abc | Continuent de fonctionner et pointent vers la première structure | Pointent vers quelque chose qu'on ne peut pas lire comme BodyStructure |
| Suppression de la première structure | La suivante prend la place de abc, donc les références doivent être réécrites | Rien ne bouge : chaque structure conserve son identifiant |
| Clients R4 | Peuvent ignorer la scission jusqu'à ce que cela importe | Doivent comprendre le OperationOutcome dès le premier jour |
Nous avons opté pour conserver abc comme ressource réelle, principalement pour que les références et clients R4 existants continuent de fonctionner. Comme pour la sémantique des recherches, je ne pense pas qu'il y ait une seule bonne réponse ici. Chaque système devra décider selon ses propres clients.
Références vers une ressource scindée
Scinder une ressource lui donne deux identités : les clients R4 voient des rangées, les clients R6 voient une ressource unique. Chaque ressource qui pointe vers un BodyStructure doit maintenant être traduite entre les deux.
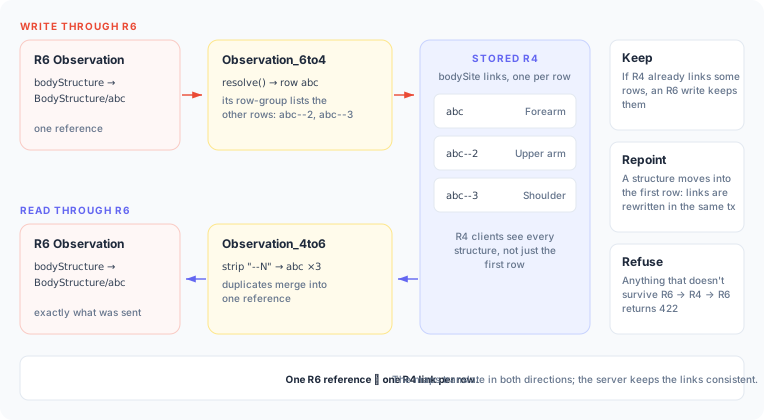
Dans R6, un Observation pointe vers un BodyStructure via bodyStructure. R4 n'a pas un tel élément, donc l'extension standard http://hl7.org/fhir/StructureDefinition/bodySite porte le lien. Comme un BodyStructure R6 correspond à plusieurs rangées R4, un seul lien ne suffit pas : en R4, BodyStructure/abc est uniquement l'avant-bras. Donc la carte R6 → R4 résout la référence et écrit un lien par rangée :
bs.reference as r where (reference.startsWith('BodyStructure/'))
  -> evaluate(r, resolve() as BodyStructure) as row
  then BodyStructureRows(row, t);

group BodyStructureRows(source row : BodyStructure, target t) {
  row.extension as g where (url = '…/bodystructure-row-group') then {
    g.extension as m where (url = 'member') then {
      m.value : Reference as member -> t.extension as x,
        x.url = 'http://hl7.org/fhir/StructureDefinition/bodySite',
        x.valueReference as v then Reference(member, v);
    };
  };
}
Au retour, Observation_4to6 supprime le suffixe --N et les doublons fusionnent en la référence unique que le client a envoyée. Trois règles du serveur assurent la cohérence :
- Conserver. Si un client R4 a restreint le lien à une seule rangée, une mise à jour R6 conserve cette restriction, car R6 ne peut pas l'exprimer.
- Réorienter. Si la première structure est supprimée, la suivante prend la place de la première rangée, et chaque Observation qui pointait vers l'ancienne rangée est réécrite dans la même transaction.
- Refuser. Tout ce qui ne survit pas à l'aller-retour R6 → R4 → R6, comme un
bodyStructurefourni sous forme de concept, est rejeté avec422.
Ce que cela signifie pour les clients R4 existants
Un seul jeu de données ne signifie pas que les clients R4 sont inchangés. Ils auront probablement besoin de quelques modifications :
- Une lecture peut être partielle.
GET /R4/BodyStructure/abcne retourne que la première structure. Les autres sont dans des rangées qu'un client ne trouve qu'à travers l'extension row-group. - Les données R6 arrivent sous forme d'extensions. Les classes d'Encounter supplémentaires et le
statusReasond'Observation, par exemple, sont des extensions inter-versions. Un client qui les ignore manque des données, et celui qui les supprime lors d'une mise à jour s'en remet au serveur pour les conserver (le nôtre le fait). - La recherche trouve moins. R4
classne correspond pas à une classe qui n'existe que dans R6. Le client doit connaîtreclass-r6. - Les données changent sous leurs pieds. Les références pointent vers des rangées qui peuvent bouger, et le serveur réécrit les Observations lorsque c'est le cas. Les versions changent sans que le client n'écrive, donc les conflits
If-Matchdeviennent plus probables.
Conclusions
1. C'est davantage un exercice de modélisation que technique
L'aspect technique a tenu bon. Un seul moteur FML a exécuté les cartes R4 → R6 générées sans modification, et des cartes écrites à la main ont couvert les renommages, la traduction de codes, les listes repliées en une seule valeur plus des extensions, et une ressource scindée en plusieurs. FML est un moteur de correspondance adapté à cette architecture. Le gestionnaire canonique, fhirschema et PostgreSQL ont fait leur travail.
Les questions difficiles portaient toutes sur le modèle, et la spécification ne vous répondra pas à votre place. R4 et R6 offrent des formes différentes pour les mêmes données : une classe ou une liste de classes, un seul body structure ou plusieurs, un site corporel codé ou une référence. Décider comment une forme devient l'autre dépend de ce que les données signifient dans votre système, ce qui fait que votre propre modélisation métier se retrouve dans les correspondances. Aucune version de la spécification ne prendra ces décisions à votre place.
2. La modélisation doit rester modifiable
Ces décisions changeront. Les travaux inter-versions de HL7 publieront des conventions, vos clients pousseront dans d'autres directions, et certains choix s'avéreront erronés. Les règles doivent donc être visibles et réversibles, et non enfouies dans le code : des cartes plutôt que des conversions écrites à la main, des paramètres de recherche qui sont des définitions publiées, et une liste documentée de ce qui va où.
Il y a un piège : parce que le dépôt est R4, chaque décision de modélisation est aussi un format de stockage. Nous avons modifié une fois l'URL de l'extension de classe Encounter pendant le hackathon, et les Encounters déjà stockés sous l'ancienne URL ont silencieusement perdu leur classe supplémentaire dans la vue R6. Revenir sur une décision signifie migrer les données écrites sous celle-ci, alors planifiez-le dès le départ.
3. Les clients R4 ne s'en tireront pas sans modifications
Il est tentant de penser aux extensions inter-versions comme à des données supplémentaires qu'un client R4 peut ignorer sans risque. Ce n'est pas le cas. Ce qui s'y retrouve est souvent le cœur du dossier : le lien d'un Observation vers les structures corporelles qu'il décrit, la deuxième classe d'un Encounter, les rangées d'un BodyStructure au-delà de la première. Un client qui les ignore ne manque pas seulement un détail. Il obtient une mauvaise réponse, et ses recherches se comportent différemment de celles en R6. Les clients R4 existants auront besoin d'au moins quelques modifications pour lire les données correctement.
Essayez-le
- Code, cartes et tests : github.com/aleksandrkislitsyn/fml-r4-r6-fhir-server. Le README explique comment l'exécuter, et
docs/mappings.htmldocumente chaque décision de correspondance. - Pour en savoir plus sur R6 : Date de sortie de FHIR R6 et nouveautés, FHIR R4 vs R5 vs R6, R6 : Soustraction par ressources supplémentaires et R6 : Que se passe-t-il pour une référence quand sa cible va en incubateur.