

Por qué un único servidor para dos versiones
R6 está en sus últimas votaciones, y la pregunta ha cambiado. Ya no es «qué hay de nuevo en R6», sino «cuánto tiempo lo ejecutaremos junto a R4». Todo lo que sabemos indica que: durante años.
- La regulación fija las versiones. La certificación estadounidense (US Core) y las reglas de interoperabilidad de CMS para Patient Access, Provider Access, Payer-to-Payer y Prior Authorization se basan todas en R4. Las nuevas normas vendrán con períodos de transición, no con una fecha de corte. Otras jurisdicciones avanzan según sus propios calendarios.
- Los socios no actualizan al mismo tiempo. Si usted es una plataforma, un HIE o un pagador, recibirá la unión de las versiones de todos.
- Las colas largas son normales. Epic todavía sirve DSTU2, STU3 y R4, cada uno en su propia URL base. Oracle Health supuestamente ejecutó DSTU2 junto a R4 durante unos seis años antes de retirarlo en 2025.
- R5 fue mayoritariamente omitido. Los sistemas en producción se quedaron en R4 y adoptaron las funcionalidades de R5 que necesitaban, como las Subscriptions basadas en temas, mediante IGs de backport para R4. Por tanto, el salto realista es de R4 directamente a R6, con todos los cambios de R4 → R5 y R5 → R6 de una vez.
- Los datos sobreviven a las versiones. Los registros escritos hoy se leerán en diez o veinte años. Los archivos históricos y las pistas de auditoría no se reescriben.
Los cambios tampoco son cosméticos. Algunos con los que nos encontramos:
| R4 | R6 | Por qué es problemático |
|---|---|---|
Encounter.class: un Coding | Encounter.class: una lista de CodeableConcept | Varias clases no caben en una |
Encounter.status finished, onleave, arrived | completed, on-hold, in-progress + subjectStatus | Códigos distintos, sin correspondencia uno a uno |
Encounter.period, hospitalization, participant.individual | actualPeriod, admission, participant.actor | Renombrados |
BodyStructure.location y morphology: uno de cada | BodyStructure.includedStructure: uno o más | Un recurso R6 puede describir lo que R4 necesita varios recursos para representar |
Observation.bodySite: un código | añade Observation.bodyStructure: una referencia | R4 no tiene ningún elemento para almacenar el enlace |
La coexistencia, pues, está garantizada. La verdadera pregunta es cómo llevarla a cabo dentro de un único sistema.
Lo que dijo la sala en el FHIR Camp
En el HL7 FHIR Camp 2026 en Cascais, Portugal, organicé una sesión Birds-of-a-Feather titulada Coexistencia de múltiples versiones FHIR en el mismo sistema. La pregunta: ¿debe un sistema servir varias versiones desde un único conjunto de datos con conversores, mantener una copia separada por versión, o almacenar cada recurso en la versión en que llegó?
La respuesta de la sala fue clara: la gente quiere un único conjunto de datos. Las razones son prácticas:
- Una única fuente de verdad. Un paciente existe una sola vez. Con una copia por versión, las copias divergen y alguien tiene que decidir cuál es la correcta.
- Sin carreras entre versiones. Si una copia R4 y una copia R6 aceptan escrituras simultáneamente, dos clientes pueden modificar el mismo registro al mismo tiempo a través de versiones distintas. Sincronizarlos implica conflictos, problemas de ordenación y reglas de fusión. Con un único almacén, cada escritura va a la misma fila e
If-Matchfunciona independientemente de la versión que utilice el cliente. - Un único historial y una única pista de auditoría. Las versiones, eliminaciones y la provenance se registran una sola vez, no una vez por copia.
- Un único lugar para buscar y analizar. Las consultas no necesitan saber en qué versión llegó un recurso.
Eso deja un único diseño: un almacén único, con cada versión servida como una proyección del mismo. También concentra toda la dificultad en un solo lugar: la conversión. Esta debe funcionar en ambas direcciones, con datos reales, en cada petición.
Un proyecto de hackathon
Así que lo convertimos en un proyecto de hackathon, con dos objetivos: ver hasta dónde llega el diseño de conjunto de datos único, y evaluar si FHIR Mapping Language (FML) es un motor de mapeo adecuado para esta arquitectura.
El equipo: Brian Postlethwaite, Artur Kurvits, Patrick Werner, Francisco Novillo Perez, Vadim Peretokin, Ralf Pohl y Aleksandr Kislitsyn.
Un agradecimiento especial a Gino Canessa. No formaba parte del equipo, pero compartió algunos de los casos más difíciles, los que son complicados de resolver correctamente.
La configuración
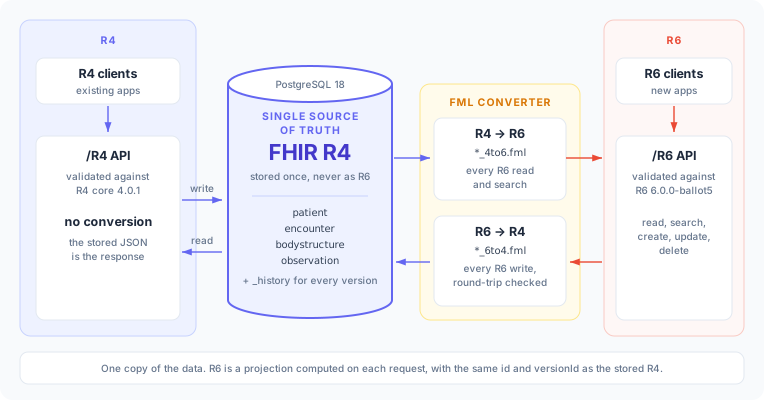
El servidor es pequeño a propósito:
- Un almacén, solo FHIR R4. PostgreSQL 18, una tabla por tipo de recurso más una tabla de historial. Elegimos R4 porque ahí es donde están los datos y los clientes actuales. Con R6 como almacén, las mismas conversiones simplemente se ejecutarían en sentido inverso.
- Dos APIs.
/R4lee y escribe el JSON almacenado sin ninguna conversión./R6lee, busca, crea, actualiza y elimina mediante FHIR Mapping Language (FML). - El motor FML es el ejecutor FML de Brian Postlethwaite de FHIRPath Lab. Ejecuta sus mapas generados de R4 → R6 sin modificación, importaciones incluidas: 164 mapas. La dirección R6 → R4 consta de 63 mapas: tipos de datos invertidos respecto a los generados, más mapas escritos a mano para Patient, Encounter, BodyStructure y Observation.
- La validación utiliza R4 4.0.1 y R6 6.0.0-ballot5, cargados con
@atomic-ehr/fhir-canonical-managery verificados con@atomic-ehr/fhirschema.
Una regla lo mantiene todo cohesionado: cada escritura, desde cualquier versión, debe ser válida en ambas versiones y superar el viaje de ida y vuelta R6 → R4 → R6.
Cada respuesta R6 lleva el mismo id y versionId que el recurso R4 almacenado, de modo que ambas versiones siempre coinciden en qué registro y qué versión están consultando.
Patient: el caso sencillo
Patient ha sido normativo desde R4 y apenas ha cambiado. El mapa generado es una copia campo a campo, y funciona sin modificaciones. R6 añade tres elementos a Patient.contact: role, additionalName y additionalAddress. En el camino hacia R4, se almacenan en extensiones entre versiones, y vuelven a salir en el camino hacia R6.
Este patrón se repite a lo largo del proyecto, por lo que merece enunciarse una vez. FHIR define un esquema de URL para las extensiones entre versiones, http://hl7.org/fhir/[version]/StructureDefinition/extension-[element], para datos que no tienen cabida en la otra versión. http://hl7.org/fhir/6.0/StructureDefinition/extension-Patient.contact.role es el Patient.contact.role de R6, almacenado en R4.
Encounter: donde las versiones realmente difieren
Un cliente R6 crea un Encounter con dos clases y un estado completed:
POST /R6/Encounter

{
  "resourceType": "Encounter",
  "status": "completed",
  "class": [
    { "coding": [{
        "system": "http://terminology.hl7.org/CodeSystem/v3-ActCode",
        "code": "AMB" }] },
    { "coding": [{
        "system": "http://terminology.hl7.org/CodeSystem/v3-ActCode",
        "code": "VR" }] }
  ],
  "participant": [{ "actor": { "reference": "Practitioner/dr-smith" } }],
  "actualPeriod": { "start": "2026-11-06T09:00:00Z", "end": "2026-11-06T09:30:00Z" },
  "admission": { "admitSource": { "text": "Referral" } }
}
El Encounter_6to4.fml escrito a mano lo convierte a R4. Los códigos de estado siguen el ConceptMap R5 → R4 de HL7, ya que R5 y R6 los comparten. La primera clase se convierte en el class de R4, cada clase adicional se convierte en una extensión entre versiones, y los elementos renombrados recuperan sus nombres en R4:
conceptmap "EncounterStatus" {
  s:"planned"   - t:"planned"
  s:"on-hold"   - t:"onleave"
  s:"completed" - t:"finished"
  …
}

group Encounter(source src : EncounterR6, target tgt : EncounterR4) extends DomainResource <<type+>> {
  src.status as v where ($this != 'in-progress' and $this != 'discharged')
    -> tgt.status = translate(v, '#EncounterStatus', 'code');
  src.class first as c -> tgt.class as k then EncounterFirstClass(c, k);
  src.class not_first as v -> tgt.extension as x,
    x.url = 'http://hl7.org/fhir/6.0/StructureDefinition/extension-Encounter.class',
    x.valueCodeableConcept as t then CodeableConcept(v, t);
  src.actualPeriod -> tgt.period;                       // renamed
  …
}
Esto es lo que se almacena y lo que lee un cliente R4:
{
  "resourceType": "Encounter",
  "status": "finished",
  "class": {
    "system": "http://terminology.hl7.org/CodeSystem/v3-ActCode",
    "code": "AMB"
  },
  "extension": [{
    "url": "http://hl7.org/fhir/6.0/StructureDefinition/extension-Encounter.class",
    "valueCodeableConcept": {
      "coding": [{
        "system": "http://terminology.hl7.org/CodeSystem/v3-ActCode",
        "code": "VR"
      }]
    }
  }],
  "participant": [{ "individual": { "reference": "Practitioner/dr-smith" } }],
  "period": { "start": "2026-11-06T09:00:00Z", "end": "2026-11-06T09:30:00Z" },
  "hospitalization": { "admitSource": { "text": "Referral" } }
}
Leerlo de vuelta a través de /R6 devuelve exactamente lo que el cliente envió, más id y meta. La verificación del viaje de ida y vuelta lo garantiza antes de aceptar la escritura.
¿Es la traducción de estados con pérdida de información?
translate() por sí solo solo es seguro cuando los códigos se corresponden uno a uno. R6 tiene más códigos de estado para Encounter que R4, por lo que algunos de ellos se colapsan:
| Estado R6 | Estado R4 | ¿Con pérdida usando solo translate()? |
|---|---|---|
completed | finished | No |
on-hold | onleave | No |
discharged | finished | Sí: finished se lee de vuelta como completed |
discontinued | sin código R4 | Sí: no hay nada a lo que traducirlo |
Para un caso de muchos a uno como discharged, el mapa almacena el código R4 más cercano y conserva el código R6 original en una extensión entre versiones sobre el propio elemento. Esa es la regla de HL7 para los bindings requeridos con códigos adicionales:
{
  "status": "finished",
  "_status": {
    "extension": [{
      "url": "http://hl7.org/fhir/6.0/StructureDefinition/extension-Encounter.status",
      "valueCode": "discharged"
    }]
  }
}
Un cliente R4 ve un estado R4 válido. La dirección R6 comprueba primero la extensión, de modo que discharged vuelve como discharged, no como completed. Así pues, el enfoque general es: traducir donde los códigos coincidan y, donde no coincidan, conservar el valor original junto al traducido.
discontinued aún no está resuelto. No tiene ningún código R4, así que por ahora se rechaza una escritura que lo utilice en lugar de almacenarla con un estado inferido.
Búsqueda significa cosas diferentes en cada versión
El Encounter almacenado ahora tiene la clase AMB de forma nativa y VR en una extensión. ¿Qué búsquedas deberían encontrarlo por VR?
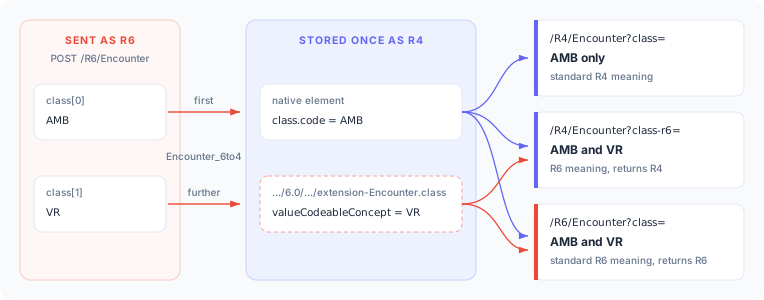
Para R6 la respuesta es sencilla: class es una lista, VR está en ella, así que class=VR coincide. La pregunta es qué debería hacer R4 class.
Opción 1: dar a R4 class el significado de R6. Podríamos haber hecho que el parámetro R4 también buscara en la extensión entre versiones. Entonces ambas versiones devolverían los mismos Encounters para la misma consulta. Pero fíjese en lo que recibe un cliente R4: pregunta por class=VR y recibe un Encounter cuyo class es AMB. El valor que buscó no está en el campo al que hace referencia el nombre del parámetro, sino en una extensión que el cliente puede no llegar a leer. La búsqueda contradiría la forma de los datos que ve el cliente.
Opción 2: mantener el significado estándar. R4 class solo coincide con lo que está en R4 class, por lo que encuentra el Encounter por AMB pero no por VR. Los resultados son coherentes con el recurso que recibe el cliente R4, y los parámetros estándar conservan su definición publicada. El coste: los mismos datos almacenados responden a la misma pregunta de forma diferente según la versión a través de la que se consulten.
Elegimos la opción 2 y añadimos un parámetro explícito para los clientes R4 que quieran el comportamiento de R6:
- R6
classcoincide conAMByVR: el significado estándar de R6. - R4
classcoincide solo conAMB: el significado estándar de R4. - R4
class-r6coincide conAMByVR: el significado de R6, activado explícitamente por nombre, devolviendo recursos R4.
¿Es esa la mejor respuesta? No estoy seguro de que exista una única correcta. Una aplicación R4 que muestra lo que hay en class prefiere la opción 2. Un informe que necesita contar todas las visitas virtuales, independientemente de la versión en que se escribieron, prefiere el significado de R6. Cada implementador tendrá que decidir para su propio caso de uso. Lo importante es elegir deliberadamente y hacer la elección visible para los clientes, en lugar de ocultarla dentro de un parámetro estándar.
Definimos class-r6 como un SearchParameter R4 propio en un pequeño paquete FHIR local. El canonical manager lo carga junto al núcleo de R4, el servidor lo sirve en /R4/SearchParameter/Encounter-class-r6, y el CapabilityStatement hace referencia a él:
{
  "resourceType": "SearchParameter",
  "url": "http://example.org/fhir/SearchParameter/Encounter-class-r6",
  "derivedFrom": "http://hl7.org/fhir/SearchParameter/Encounter-class",
  "code": "class-r6",
  "base": ["Encounter"],
  "type": "token",
  "expression": "Encounter.class | Encounter.class.extension('http://hl7.org/fhir/6.0/StructureDefinition/extension-Encounter.class').value | Encounter.extension('http://hl7.org/fhir/6.0/StructureDefinition/extension-Encounter.class').value"
}
La búsqueda en sí se ejecuta como SQL sobre el R4 almacenado. FML solo convierte los resultados para /R6.
BodyStructure: un recurso, varias filas
BodyStructure es donde los dos modelos dejan de alinearse. En R6, includedStructure es una lista: un BodyStructure puede describir una lesión en el antebrazo, el brazo superior y el hombro. R4 tiene un único location y una única morphology.
Nuestra solución, que es diseño propio y no de HL7, consiste en almacenar un BodyStructure R6 como un recurso R4 por estructura, con ids abc, abc--2, abc--3. Una extensión gestionada por el servidor las vincula: la primera fila lista las demás, y cada fila adicional apunta de vuelta a la primera.
GET /R4/BodyStructure/abc

{
  "resourceType": "BodyStructure",
  "id": "abc",
  "location": { "text": "Forearm" },
  "extension": [{
    "url": "http://example.org/fhir/StructureDefinition/bodystructure-row-group",
    "extension": [
      { "url": "position", "valuePositiveInt": 1 },
      { "url": "member", "valueReference": { "reference": "BodyStructure/abc--2" } },
      { "url": "member", "valueReference": { "reference": "BodyStructure/abc--3" } }
    ]
  }]
}
El resto se deriva de esto:
- Una escritura reescribe el conjunto completo de filas en una transacción, desde cualquier versión.
- Los valores exclusivos de R6 van en extensiones entre versiones, como morfologías adicionales, lateralidad y puntos de referencia anatómicos.
- Los ids de fila permanecen estables, y el
includedStructure.idde R6 de cada estructura es su número de fila. - R6 solo muestra
abc.GET /R6/BodyStructure/abc--2devuelve404.
Existe otra forma de dividir, que posiblemente sea la más clara. Numerar cada estructura, abc--1, abc--2, abc--3, y no almacenar ningún recurso R4 llamado abc. Una lectura de GET /R4/BodyStructure/abc devolvería entonces un OperationOutcome que lista los ids reales:
GET /R4/BodyStructure/abc

{
  "resourceType": "OperationOutcome",
  "issue": [{
    "severity": "information",
    "code": "informational",
    "diagnostics": "BodyStructure/abc is stored in R4 as three resources: BodyStructure/abc--1, BodyStructure/abc--2, BodyStructure/abc--3"
  }]
}
Los compromisos van en ambas direcciones:
abc, abc--2, abc--3 (lo que construimos) | abc--1, abc--2, abc--3 + OperationOutcome | |
|---|---|---|
Leer abc a través de R4 | Devuelve la primera estructura, que parece el conjunto completo | Indica claramente que está dividido y dónde están las partes |
Referencias R4 existentes a abc | Siguen funcionando y apuntan a la primera estructura | Apuntan a algo que no se puede leer como BodyStructure |
| Eliminar la primera estructura | La siguiente pasa a ocupar abc, por lo que las referencias deben reescribirse | Nada se mueve: cada estructura conserva su id |
| Clientes R4 | Pueden ignorar la división hasta que sea relevante | Deben entender el OperationOutcome desde el primer día |
Optamos por mantener abc como un recurso real, principalmente para que las referencias y los clientes R4 existentes sigan funcionando. Al igual que con la semántica de búsqueda, no creo que haya una única respuesta correcta. Cada sistema tendrá que decidir en función de sus propios clientes.
Referencias a un recurso dividido
Dividir un recurso le da dos identidades: los clientes R4 ven filas, los clientes R6 ven un único recurso. Todo recurso que apunte a un BodyStructure ahora debe traducirse entre ambos.
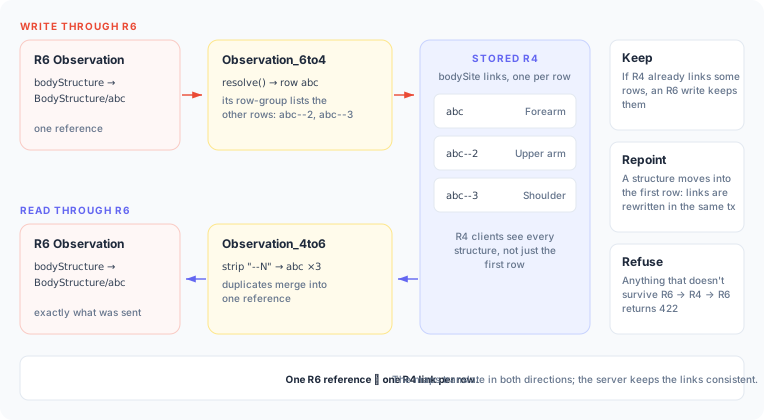
En R6, un Observation apunta a un BodyStructure mediante bodyStructure. R4 no tiene ese elemento, por lo que la extensión estándar http://hl7.org/fhir/StructureDefinition/bodySite lleva el enlace. Como un BodyStructure de R6 corresponde a varias filas R4, un único enlace no es suficiente: en R4, BodyStructure/abc es solo el antebrazo. Por eso el mapa R6 → R4 resuelve la referencia y escribe un enlace por fila:
bs.reference as r where (reference.startsWith('BodyStructure/'))
  -> evaluate(r, resolve() as BodyStructure) as row
  then BodyStructureRows(row, t);

group BodyStructureRows(source row : BodyStructure, target t) {
  row.extension as g where (url = '…/bodystructure-row-group') then {
    g.extension as m where (url = 'member') then {
      m.value : Reference as member -> t.extension as x,
        x.url = 'http://hl7.org/fhir/StructureDefinition/bodySite',
        x.valueReference as v then Reference(member, v);
    };
  };
}
En el camino de vuelta, Observation_4to6 elimina el sufijo --N y los duplicados se fusionan en la referencia única que el cliente envió. Tres reglas del servidor mantienen la coherencia:
- Conservar. Si un cliente R4 redujo el enlace a una sola fila, una actualización R6 mantiene esa restricción, porque R6 no puede expresarla.
- Reapuntar. Si se elimina la primera estructura, la siguiente pasa a ocupar la primera fila, y cada Observation que apuntaba a la fila antigua se reescribe en la misma transacción.
- Rechazar. Todo lo que no supere el viaje R6 → R4 → R6, como un
bodyStructureproporcionado como concepto, se rechaza con422.
Qué significa esto para los clientes R4 existentes
Un único conjunto de datos no significa que los clientes R4 no se vean afectados. Probablemente necesitarán algunos cambios:
- Una lectura puede ser parcial.
GET /R4/BodyStructure/abcdevuelve solo la primera estructura. El resto están en filas que el cliente solo encuentra a través de la extensión row-group. - Los datos R6 llegan como extensiones. Las clases adicionales de Encounter y
statusReasonde Observation, por ejemplo, son extensiones entre versiones. Un cliente que las ignora pierde datos, y uno que las elimina en una actualización depende de que el servidor las conserve (el nuestro lo hace). - La búsqueda encuentra menos. R4
classno coincide con una clase que solo existe en R6. El cliente tiene que conocerclass-r6. - Los datos cambian sin que ellos escriban. Las referencias apuntan a filas que pueden moverse, y el servidor reescribe los Observations cuando lo hacen. Las versiones cambian sin que el cliente escriba, por lo que los conflictos de
If-Matchse vuelven más probables.
Conclusiones
1. Es un ejercicio de modelado más que técnico
La parte técnica funcionó. Un motor FML ejecutó los mapas generados R4 → R6 sin modificación, y los mapas escritos a mano cubrieron renombrados, traducción de códigos, listas plegadas en un único valor con extensiones, y un recurso dividido en varios. FML es un motor de mapeo adecuado para esta arquitectura. El canonical manager, fhirschema y PostgreSQL hicieron su trabajo.
Las preguntas difíciles fueron todas sobre el modelo, y la especificación no las responderá por usted. R4 y R6 ofrecen formas diferentes para los mismos datos: una clase o una lista de clases, una estructura corporal o varias, un código de localización corporal o una referencia. Decidir cómo una forma se convierte en la otra depende de lo que significan los datos en su sistema, por lo que el modelado de negocio propio acaba incorporándose a los mapeos. Ninguna versión de la especificación tomará esas decisiones por usted.
2. El modelado debe poder modificarse
Esas decisiones cambiarán. El trabajo entre versiones de HL7 publicará convenciones, sus clientes pondrán objeciones, y algunas elecciones resultarán erróneas. Por eso las reglas deben ser visibles y reversibles, no enterradas en el código: mapas en lugar de conversiones escritas a mano, parámetros de búsqueda que son definiciones publicadas, y una lista documentada de qué va dónde.
Hay un inconveniente: como el almacén es R4, cada decisión de modelado es también un formato de almacenamiento. Durante el hackathon cambiamos la URL de la extensión de clase de Encounter una vez, y los Encounters ya almacenados bajo la URL anterior perdieron silenciosamente su clase adicional en la vista R6. Revertir una decisión implica migrar los datos escritos bajo ella, así que planifíquelo desde el principio.
3. Los clientes R4 no podrán eludir los cambios
Es tentador pensar que las extensiones entre versiones son datos adicionales que un cliente R4 puede ignorar sin problemas. No es así. Lo que acaba en ellas suele ser el núcleo del registro: el enlace de un Observation a las estructuras corporales que describe, la segunda clase de un Encounter, las filas de un BodyStructure más allá de la primera. Un cliente que las ignora no solo pierde detalle. Obtiene una respuesta incorrecta, y sus búsquedas se comportan de forma diferente a las de R6. Los clientes R4 existentes necesitarán al menos algunos cambios para leer los datos correctamente.
Pruébelo
- Código, mapas y pruebas: github.com/aleksandrkislitsyn/fml-r4-r6-fhir-server. El README explica cómo ejecutarlo, y
docs/mappings.htmldocumenta cada decisión de mapeo. - Más sobre R6: Fecha de lanzamiento de FHIR R6 y novedades, FHIR R4 vs R5 vs R6, R6: Sustracción mediante recursos adicionales y R6: Qué ocurre con una referencia cuando su destino pasa a un incubador.